微软邮箱全球宕机:故障近十小时

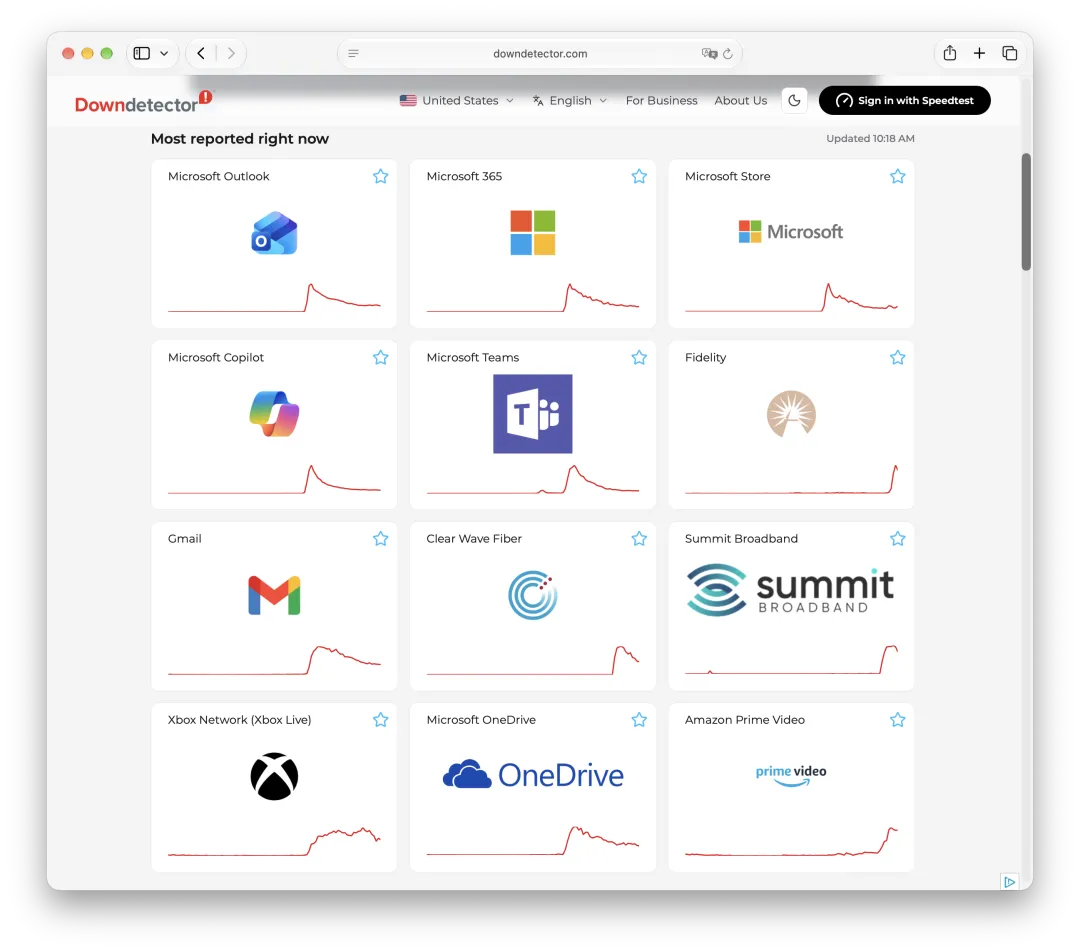
北京时间 2026 年 11 月 13 日凌晨 00:17 起,微软核心邮件基础设施 Exchange Online 突发全球级大规模宕机(EX1550543),并顺着内部共享依赖链迅速演变为波及整个 Microsoft 365 生态的级联故障(MO1550821)。事故高峰期 Downdetector 录得近 13 万条 Outlook 报错,美洲、欧洲与亚太地区企业用户全面受阻。
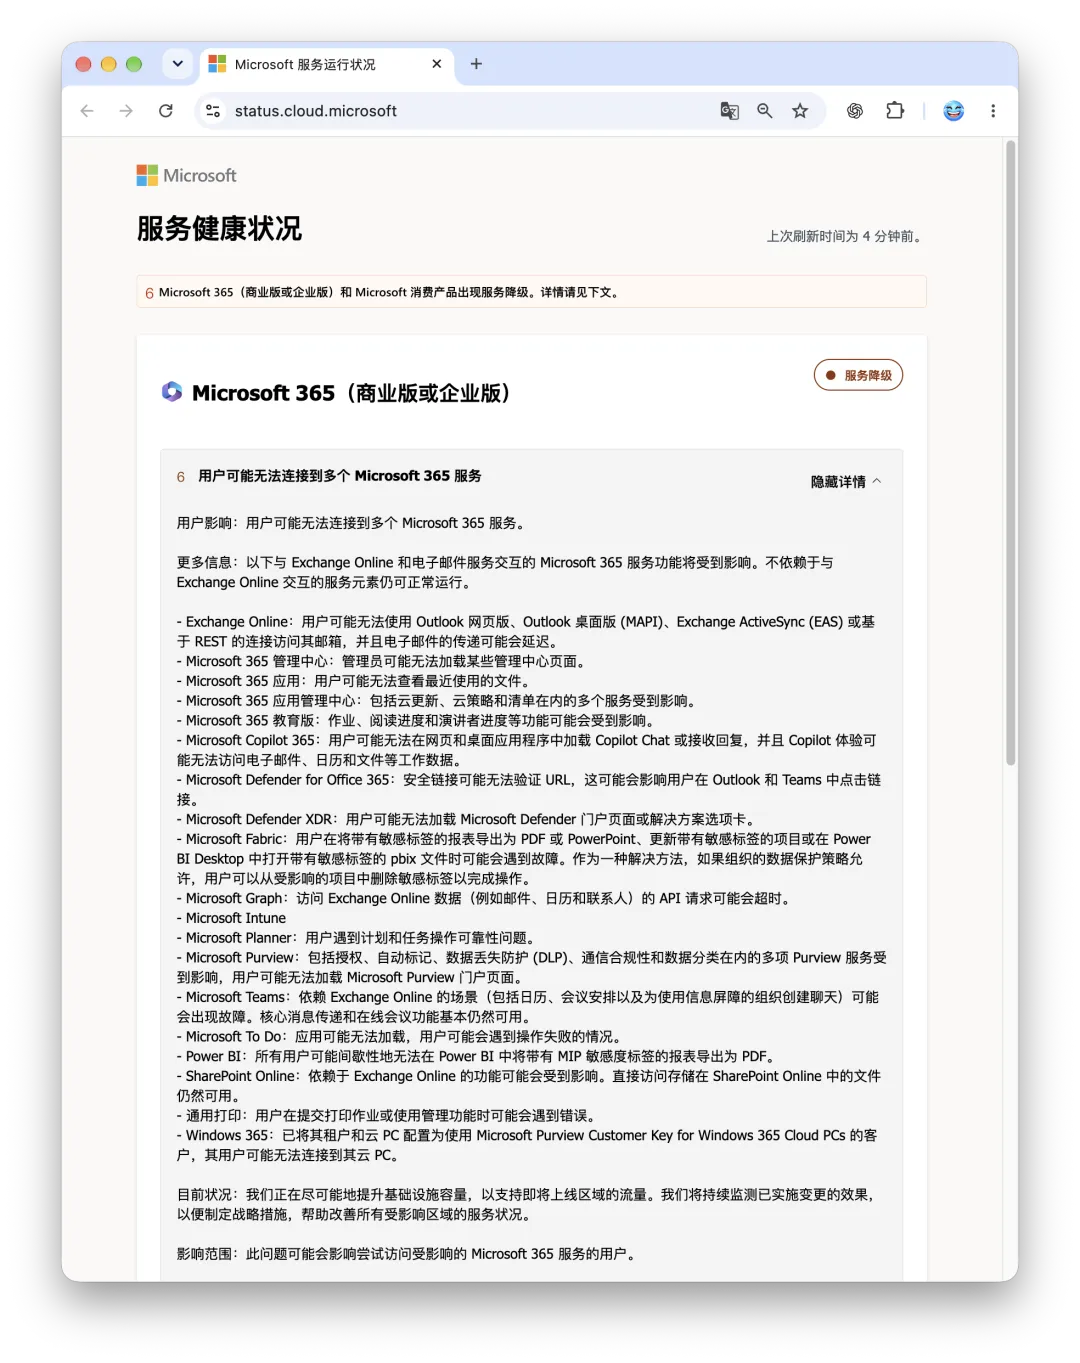
排查表明,此次事故并非外部攻击或真实流量暴涨,而是服务端负责建立安全连接的进程发生过载崩溃,叠加自动健康检查摘除节点引发剩余容量雪崩。在回滚一项与故障起点高度吻合的近期网络配置变更后,微软公共状态页目前仍显示“服务降级”,整场拉锯战已经近十个小时,精确的租户级关闭时间与最终根因仍待正式复盘报告(PIR)披露。
事实核验
北京时间 11 月 13 日凌晨 00:17,微软后台首次记录到 Exchange Online 接入异常。企业用户的网页版(OWA)、桌面端(MAPI)、移动端(EAS)及 REST 接口同时失联,邮箱彻底陷入“已断开连接”或无限转圈状态。两小时内报错迅速冲顶,Downdetector 上仅 Outlook 单项报告就逼近 13 万条,微软随即立项跨产品主工单 MO1550821,影响范围也从最初评估的“美洲局部”扩大至全球任何区域的连接。
这是一场典型的底层依赖问题。事故期间,Teams 的核心即时消息与 SharePoint 的直接文件读取大体可用,但凡是依赖 Exchange 邮件、日历与联系人数据的上下游服务全部连坐瘫痪——Microsoft Graph 相关 API 大面积超时,Teams 日程排会失效,Microsoft 365 Copilot 因读不到工作数据直接罢工,Defender 的 Safe Links 校验、Purview 合规组件乃至启用客户密钥的部分 Windows 365 云桌面纷纷报错。
故障甚至穿透微软边界,导致 OpenAI(ChatGPT) 与 Anthropic(Claude) 的 M365 企业连接器同步失灵。更讽刺的是,M365 管理中心(Admin Center)自身也一度无法加载,全球大批系统管理员连进后台看一眼故障通报的路都被堵死,只能涌向 Reddit 等社区靠网友手抄的状态镜像对表。
微软的排障过程整整折腾了近十个小时,且多次出现判断反转。官方起初将断连归咎于“多区域负载升高”,凌晨 3 点后在冻结全局变更的同时推翻了流量暴涨假说,承认高负载只是表象,真凶是大批服务器未能通过自动健康检查而被移出集群,迫使存量请求瞬间压垮了剩余节点。围绕“到底改没改过东西”,微软先是声称未发现相关近期变更,一小时后又改口正在核查少量配置更新。
凌晨 6 点至 8 点间,抢修陷入了最棘手的死胡同:微软尝试切分隔离基础设施并分批重启节点,一度观察到局部回暖,但很快发现重新上线的服务器一旦承接真实流量,便会再次失去响应。直到上午 09:06,微软才找到真正病灶——确认受影响服务器上负责建立安全连接的核心进程被压垮,在限制特定流量并用旧配置重建节点的同时,正式回滚了一项与事故爆发时间高度相关的近期网络配置变更。截至上午 10:01,微软公共健康状态页依然显示“服务降级”。
技术分析
以下是根据微软公开事故通报重建的故障传播模型,并非微软已经确认的完整根因。具体的健康检查策略、连接进程内部行为和重连流量规模,仍需等待正式 PIR 披露。
把长达十小时的零碎通报串起来看,这是一起教科书级别的“配置变更诱发容量塌缩,进而触发正反馈雪崩(Failure Amplification)”的基础设施事故,整个故障链条非常清晰:
整个过程中最致命的机制,在于自动健康检查的“拆台效应”与亚稳态死锁。健康检查的本意是摘除个别生病的单机,但在全局共因故障面前,如果负载均衡探针缺乏最大摘除比例熔断(Fail-open),它就会把成批变慢的节点逐一踢出服务池,亲手制造出毁灭性的“容量悬崖”。
而只要底层的畸形网络配置没有回滚、安全握手的异常开销没有解除,单纯重启机器毫无意义——刚拉起来的干净节点一面对全球无数客户端排山倒海的自动重连风暴,几分钟内就会再次过载暴毙。这也解释了为什么微软后半夜反复上演“刚好几分钟又断气”的拉锯战。
与此同时,这场事故也扯下了现代云端办公套件“松耦合”的遮羞布。平日里云厂商总把 SaaS 描绘成模块化、高弹性的云原生大厦,真到了关键时刻才发现,老牌的 Exchange 依然是串起企业协同、安全审计乃至前沿 AI Agent 的隐性单点。
底层邮件连接层一抖,上层算力再充沛的大模型连接器与 Copilot 也瞬间沦为断网的瞎子;至于官方账号在 X 上每条推文末尾雷打不动地叮嘱管理员“请登录 Admin Center 查看详情”,偏偏管理后台自己也打不开——生产面与管控面同生共死的架构老病,跨国巨头照样一脚踩空。
老冯评论
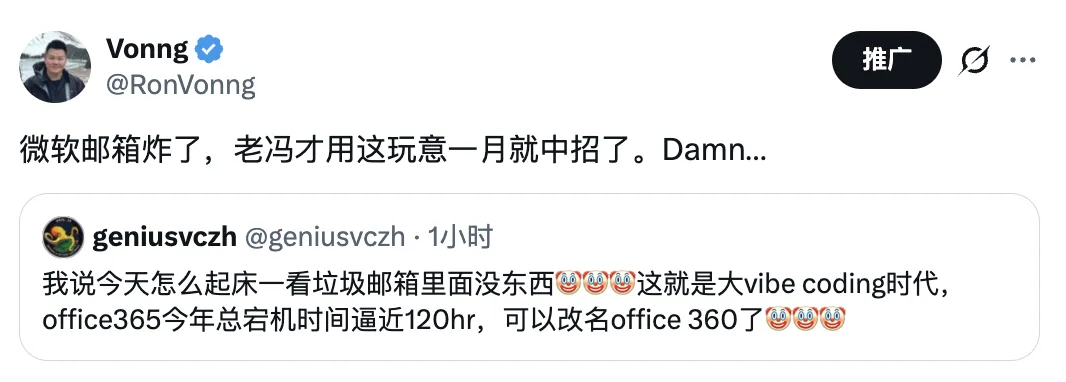
说来也是真够寸的。老冯自己的企业域名邮箱(pgsty.com)前阵子刚从 iCloud 迁移到微软企业邮箱,满打满算才用了一个月,结果今早一睁眼打开客户端,一条新邮件也没有,结结实实挨了微软这一记闷棍。毕竟邮件是少数几个老冯不建议自建的服务,因为邮箱信誉不足会被拒收,所以确实没有啥好办法。
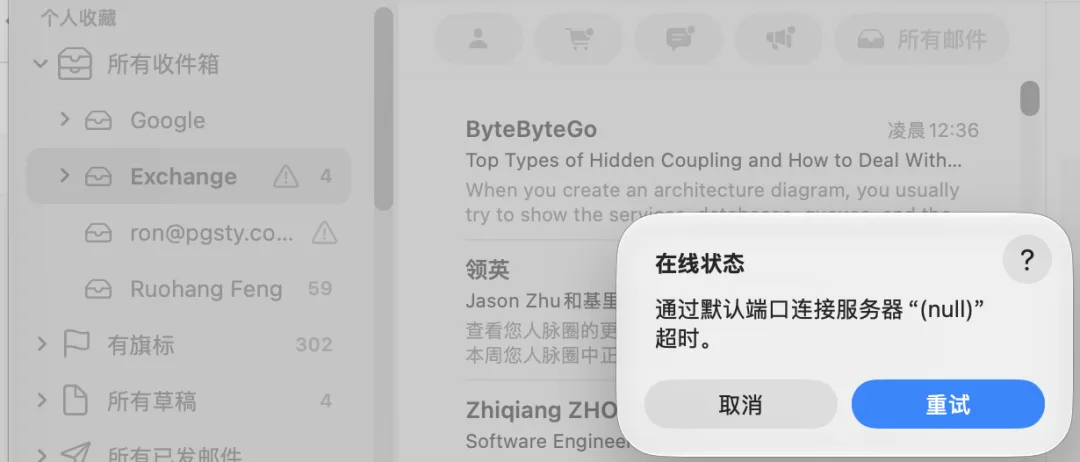
当你选择使用云巨头的服务时,你买到的不只是省事,更是全盘继承了云巨头的复杂度与风险性。
不妨退一步想想看:假如你在传统的 IDC 机房里自己托管几台物理服务器,安安分分跑一套自己的业务或者邮件系统,你几乎不可能想象 “机房因为推了一行底层网络配置,结果把我的安全连接进程和健康检查搞出死循环雪崩”这种离奇死法。
但在巨头公有云平台上,我们已经反反复复看到一样的剧本重复上演—— DNS 故障,OSS/IAM 循环依赖,白名单配错,某处控制面变更把全球租户一起带进沟里。Mega-scale 有 Mega-scale 专属的病,而这些问题在你自己的 Scale 里,根本就不会存在。
带瘫全球互联网,Google云/Cloudflare全球故障
小规模系统的问题往往是局部、直观、线性的,坏块盘、挂个进程,上去看一眼日志重启切走也就完了。而超大规模公有云为了维持全球多租户底座的运转,必须在底下叠加上百层复杂的软件定义网络、自动化健康探针、动态流量编排与多层安全网关。
这套庞然大物平时看着固若金汤,可一旦某个齿轮因为一次配置变更卡死,它引以为傲的自动化容灾机制瞬间就会变成最高效的“故障放大器”。租户却被迫为几十万台服务器组成的巨型分布式怪兽承担结构性脆弱的代价。
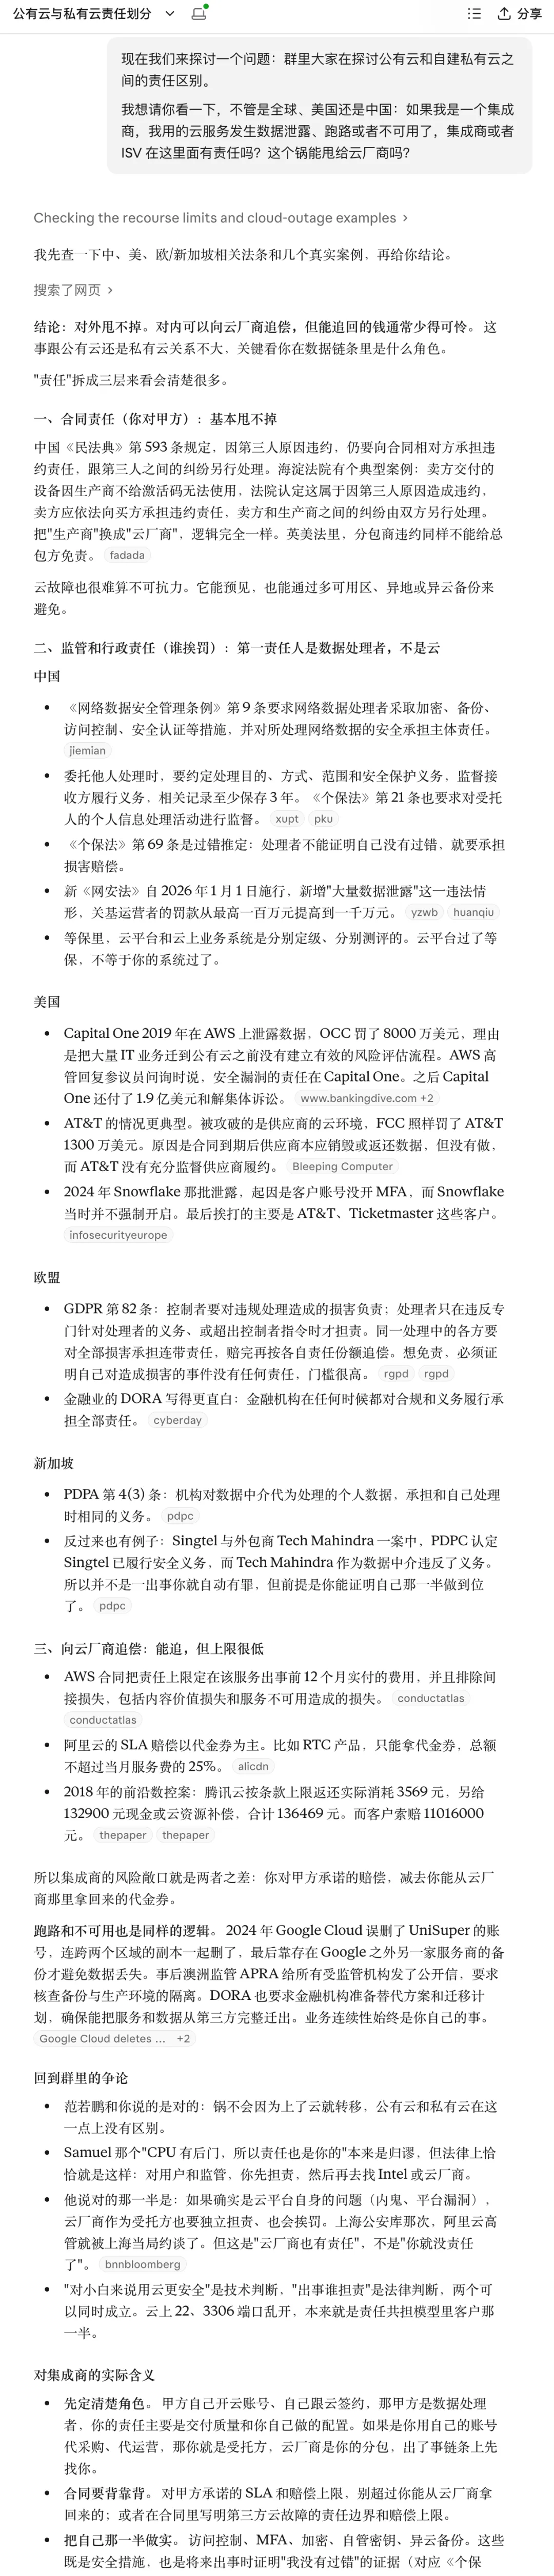
至于指望云巨头挂了之后能给你什么实质性的保证或赔付?趁早别抱幻想。微软的 Exchange Online 确实有 SLA,但它不是“服务挂了十小时,就自动赔你十小时损失”这么简单。它按适用服务、受影响用户和约定统计周期计算可用率,最终能否获得账单抵扣,还得按合同规则申请和核定。即便拿到了抵扣,也不过是相应订阅费用的一部分,赔你点代金券,跟关键邮件收不到、业务流程中断造成的真实损失,根本不是一个数量级。
说白了,上云就是签了一份“生死有命”的城下之盟:享受了它拎包入住的便利,就得默默咽下它隔三差五犯“大厂规模病”的苦果。觉得上云之后,遇上故障就能把锅甩给云厂商?别逗了,最后背锅的其实还是你自己。
专栏:云计算泥石流
云故障
带瘫全球互联网,Google云/Cloudflare全球故障
云资源
下云记