当云被打成筛子

最近这半个月,整个云服务和数据库圈子,简直像在演灾难片。
先是这两天轰动全网的 TiDB Cloud 数据泄漏事件。黑客组织 FulcrumSec 直接在泄密站点挂出了平凯星辰(PingCAP)的专页(The PingCAP TiDB Cloud Leaks),宣称从 TiDB Cloud 拖走了整整 10.6 TB 的数据,不仅发公告公开嘲讽,还直接放出了 200 GB 的第一阶段公开样本供“下载验货”。
但这不是孤例。把视线拉宽一点,你会发现最近整个云基础设施圈子正在经历一场系统性的雪崩:
- Zeabur 两度被入侵并宣布关停:曾经在开发者圈子里颇受欢迎的 PaaS 托管平台 Zeabur,继 8 月底发生环境变量外泄事故后,10 月 14 日再度遭遇致命入侵并波及底层专用服务器,最终于 10 月 17 日正式发布公告,宣布将于今年 12 月底彻底关停服务;
- 区域云与主机大厂接连爆雷:10 月 7 日,软银集团旗下的日本知名云厂商 IDCF Cloud 东日本大区遭勒索软件攻破,495 家企业与地方政府客户瞬间停摆,约 3.6 PB 数据被加密,官方甚至绝望地宣布受影响可用区的数据难以恢复,只能靠客户自己的外部备份自救;与此同时,欧洲极其硬核的主机大厂 Hetzner 也在 10 月 14 日遭遇针对 Cloud API 与控制台的攻击,导致服务一度中断;
- Supabase 1.6 万个数据库裸奔:安全机构 UpGuard 刚披露,随着 AI 辅助编程(Vibe Coding)泛滥,超过 16,000 个托管在 Supabase 上的云数据库因为公网端点暴露与行级安全(RLS)配置缺失,暴露出可被批量读取的数据。这样的配置,简直是在等着别人来“摘菜”。
这一连串新闻只是冰山一角,背后的原因是:攻防两端的底层逻辑已经彻底变天了。
在老冯看来,按照现在漏洞披露与利用的节奏,很快几乎所有联网的云服务器和云虚拟机,都可能被打成筛子。
一、PG 19 的罕见延期与漏洞海啸
为什么最近漏洞披露和云平台沦陷的速度快得如此反常?
关注 PostgreSQL 社区的朋友可能注意到了一个极不寻常的信号:一向以发版稳如钟表著称的 PostgreSQL,原本计划今年秋季发布的 19 正式版,遇到了罕见的延期——官方宣布 GA 推迟到 11 月 19 日,并在 Beta 阶段从发行说明里移除了多达 13 条、涵盖 11 项已经写好代码的新特性(包括备受瞩目的 SQL/PGQ 属性图查询、FOR PORTION OF 时态更新、MERGE/SPLIT PARTITION、在线数据校验和等)。
官方给出的直接理由,是要把 11 月小版本中的大量修复纳入 PostgreSQL 19,再发布一个 RC。这背后还有个很有意思的背景:最近有一大堆人,正在用 Claude 等大模型疯狂扫描 PostgreSQL 的源码找 Bug,找到之后就扎堆往社区提修复、报漏洞。 甚至在 8 月底,PG 核心开发者 Robert Haas 自己在 pgsql-hackers 邮件列表里发起著名的“最吓人补丁大赛(scary patch contest)”时,也是直接让 Claude 去评估哪些新特性的 Bug 最吓人。老冯自己前阵子也拿 AI 扫出来几个 PG 的 Bug。
PostgreSQL 是一座积累了三十多年的 C 语言大山,代码质量在开源界已是顶尖。但架不住如今 AI 代码审计的能力进化到了变态的程度。以前一个顶尖安全研究员要花几个月才能啃下来的内存边界条件、整数溢出、类型混淆,现在挂上大模型跑一晚上,就能给你犁出一串来。
看看最近已经公开披露的战况就知道了:就在今年 8 月 13 日的例行安全更新里,PostgreSQL 官方一口气披露并修复了 28 个 CVE 漏洞,创下了历史最高纪录,其中 14 个是 CVSS 8.8 的高危远程代码执行(RCE)。从最常用的 to_char() 函数堆缓冲区溢出(CVE-2026-14669)、pg_stat_statements 内存损坏(CVE-2026-14676),到全文检索 tsvector(CVE-2026-14662)和 fuzzystrmatch(CVE-2026-15742)的整数回绕写内存,全都被翻了个底朝天。
参见《井喷:修了 28 个 CVE、110 个 BUG,PG 最新小版本发布》。
再看次日,也就是 8 月 14 日,安全研究员 Mehmet Ince 发表了一篇震动业界的雄文,标题毫不客气地叫做《托管 PostgreSQL 行业的系统性风险》。他干了件什么事?他挑了一个随 PostGIS 一起分发、几乎所有云厂商都默认白名单放行的附属扩展 address_standardizer。
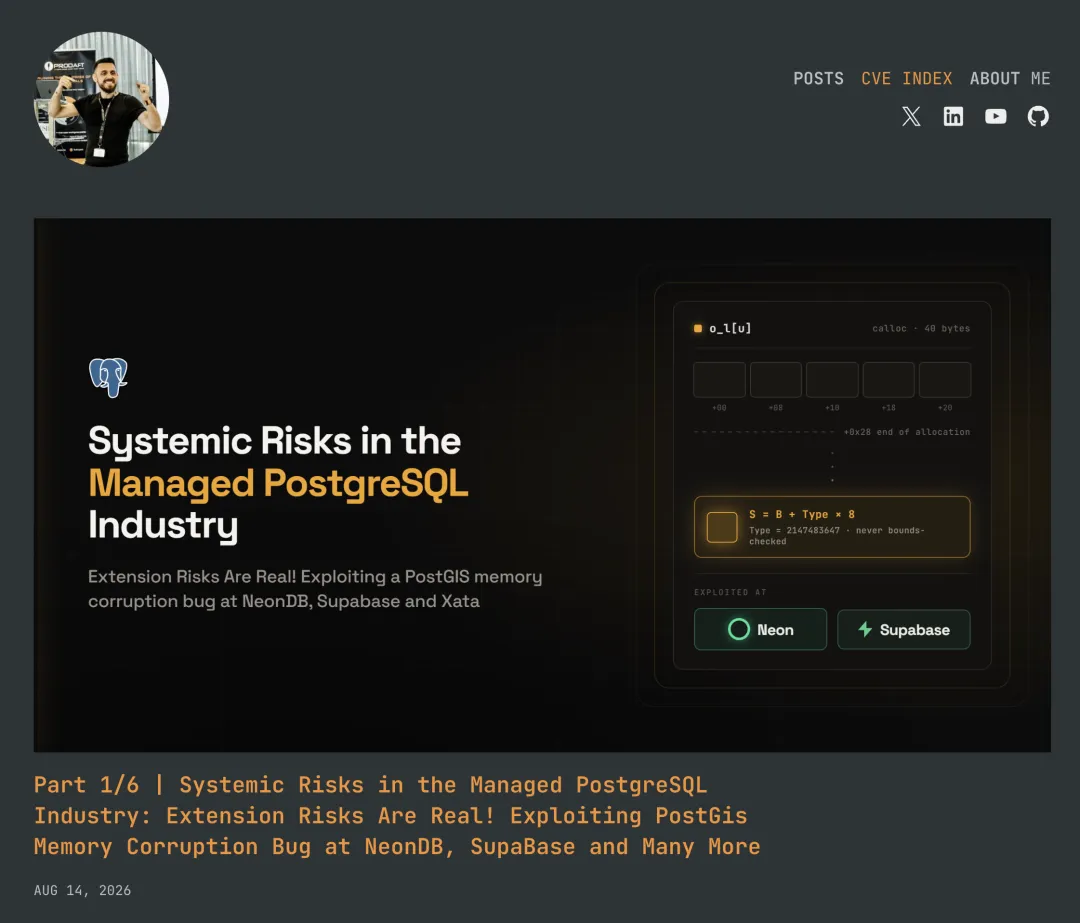
他先利用 PostGIS 的一个越界读(CVE-2026-73515)破掉内存地址随机化(ASLR),再用 address_standardizer 的越界写(CVE-2026-73514)篡改内存,甚至利用 C 编译器处理布尔值的底层汇编特性,构造出了一个能绕过部分超级用户状态检查的“影子超级用户(Shadow-Superuser)”——就这么一套丝滑的连招,直接把 NeonDB、Supabase、Xata 等一众当红 Serverless 与托管 PG 云平台全部打穿!
你以为数据库进程被打穿了,底下还有 Linux 容器和虚拟机兜底?
看看最近密集爆出的 Linux 内核 pwn 与容器/虚拟机逃逸漏洞吧:
代号为 “Copy Fail”(CVE-2026-31431) 的内核加密子系统漏洞,不依赖条件竞争,公开演示声称可以稳定触发,波及 Ubuntu、RHEL、Amazon Linux 等主流发行版的受影响内核。它让本地非特权用户有机会篡改页面缓存(page cache)并提权;在满足利用条件的共享内核容器环境中,还可能危及宿主机和其他租户。而且,针对缓存的修改可以不改变磁盘上原文件的内容,仅盯着文件哈希的监控就可能漏过去。
还有 10 月 15 日披露的 PwnEscape(CVE-2026-99999,CVSS 9.3),一个在 Linux 内核 IPv4 网络栈里潜伏了整整 18 年的 skb_checksum_help() 越界写漏洞。各大发行版通告写得明明白白:不可信的客户虚拟机(Untrusted Guest VM)可以通过虚拟网卡发送带有畸形校验和元数据的网络包,就能直接泄漏或破坏宿主机内核内存,甚至在宿主机上实现虚拟机逃逸并以 root 权限执行任意代码。AlmaLinux 的通告也确认了这个风险。不过要分清演示范围:Vercel 披露的生产环境演示是宿主机内存泄漏;宿主机崩溃与 root 代码执行,则是在研究员搭建的同配置 KVM / Firecracker 环境中完成的!
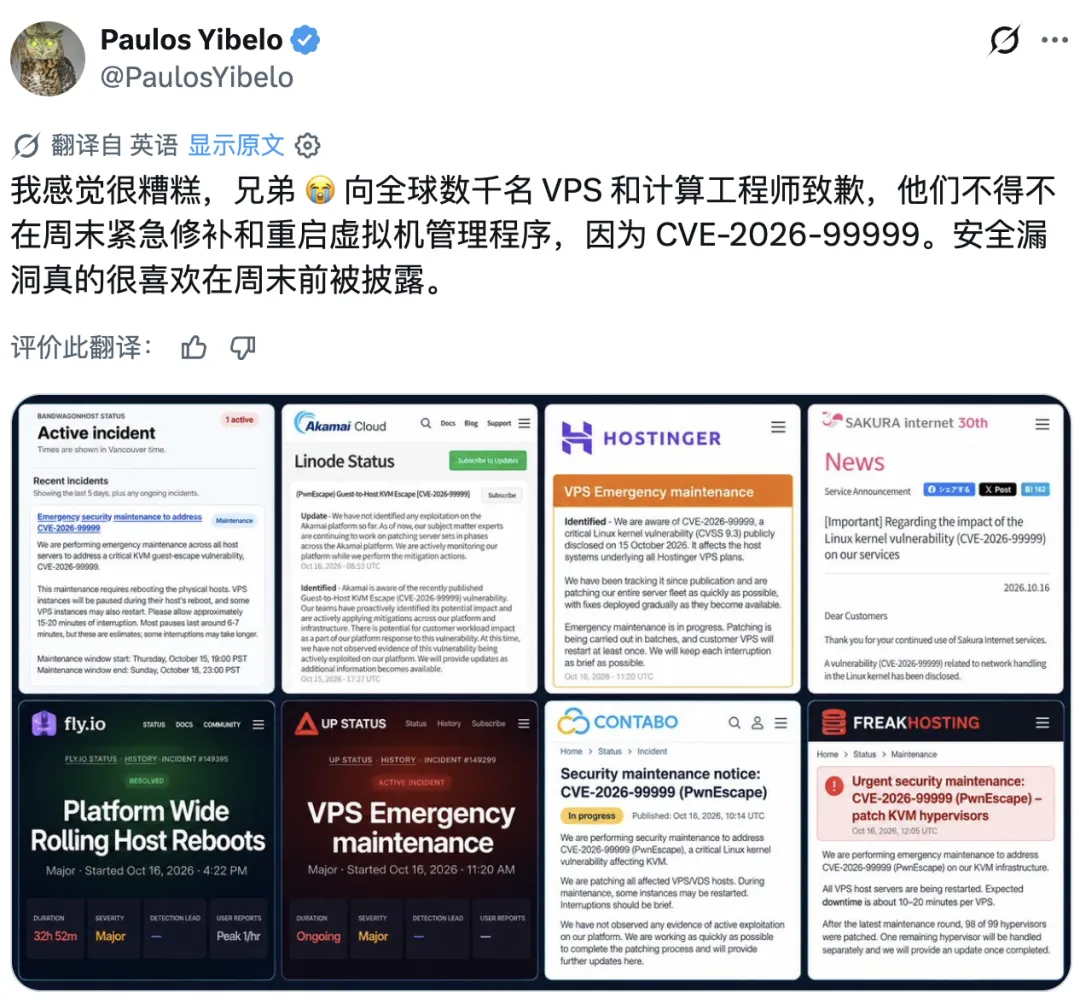
应用层扩展内存损坏、数据库内核 RCE、容器 Page Cache 污染、再到 KVM 虚拟机网络包逃逸……整条防线,从上到下,全在漏风。
二、为什么云厂商注定会被打成筛子?
回到开头的判断:为什么老冯觉得按现在这种 AI 辅助挖洞的速度,几乎所有公有云的服务器和数据库迟早都会被打成筛子?这不怪哪一家云厂商不努力,这是开源软件开发模式与公有云多租户运维模式之间不可调和的物理矛盾。
你想想看,现在黑客甚至都不需要自己拿 Claude 去扫 0-day,他们只需要干一件事:盯着 Linux 和 PostgreSQL 的公开 git commit log 看就可以了。 开源项目主干上的代码提交和普通 Bug 修复是公开可见的;有些修复最初未被识别为安全问题,却已经暴露了足够多的线索。比如今天某个核心开发者在 PG 的主干分支上提交了一个 Patch,修掉了一个“在特定边界条件下会导致内存越界写”的 Bug,commit message 里写得清清楚楚。
对于黑客(或者黑客挂载的自动化 AI Agent)来说,看到这个 commit,就能开始反向分析利用条件;对部分漏洞来说,做出攻击原型可能只需要几分钟。但云厂商呢?云厂商的响应速度,在机制上就根本不可能跟得上上游的 commit 节奏!
拿 PostgreSQL 来说,社区通常每季度发布一次小版本(Minor Release),遇到重要缺陷或安全问题也会安排额外发布。已确认的安全漏洞有非公开协调流程,并不是一律先公开补丁、再等几个月发版。但对已经公开的普通修复,以及补丁发布后尚未升级的实例,时间差依然存在。等社区发了版,各家云厂商还要拉取代码、合入自己的魔改分支、做控制面兼容性测试、安排灰度发布窗口……折腾完一圈推送到客户的实例上,黄花菜都凉了。
我在数据库行业干了这么多年,从来没见过哪家云厂商敢跟着数据库或者 Linux 内核的 master 主干 commit 走,每天给线上成千上万个生产实例热更新的。这在工程上根本不现实,真这么干,不用黑客动手,云厂商自己就把自己升级挂了。
于是,一个长达几周甚至几个月的“致命时间差”就诞生了:修复或利用线索已经公开,全世界都能研究哪里有块砖是松的;而那些尚未更新的云主机和多租户云数据库,仍然挂在公网上,或者跟无数来历不明的隔壁租户挤在同一台物理宿主机上,排队等着几个月后的补丁窗口。
以前也是这样,但 AI 改变了一切,上层 AI 鬼火编程导致的配置雪崩,底层 AI 自动化挖洞利用导致的隔离击穿。
以前这些底层漏洞利用技术还可以说掌握在一个相对克制、隐蔽的专业安全群体手里;现在拿着 “破甲版” GLM / Qwen 或者类似无限制大模型的脚本小子,甚至都不需要自己看懂汇编和内存布局,对着公开的 commit log 就能让 AI 自动生成 PoC 开始嘎嘎乱杀了。
在联网和多租户的前提下,这个时间差就是单向透明的屠杀场,会把云打成筛子。
题外话:商业软件会更安全吗?
看到这里,肯定会有卖闭源商业软件的朋友跳出来说:“你看!开源软件因为代码公开、Commit 透明才会被 AI 盯着打,所以大家为了安全,应该去买源码保密的商业闭源软件!”如果你真信了这种鬼话,那才叫刚出狼窝,又入虎穴。
安全界有一条铁律:永远不要靠“隐蔽性”来博取安全(Security through Obscurity)。 觉得“把源码藏起来黑客就找不到 Bug”,本质上就是掩耳盗铃。当攻击成本出现多个数量级的断崖式下降,原来那些因为“做得烂”、“没人用”、“没人会去仔细看”而裱糊出来的闭源茅草屋,恐怕会在这波浪潮中被一波吹翻——开头那些接连沦陷的云平台自研控制面,就已经在给我们上演鲜活的案例了。
首先,现在市面上绝大多数打着“自主可控、企业级安全”旗号的商业数据库,扒开皮一看,底层十有八九还是基于 PostgreSQL 或 MySQL 早期版本拉出来的魔改分支。上游开源社区爆出来的陈年漏洞,它们祖传代码里一个都少不了;更要命的是,因为自己的魔改代码跟上游早就分道扬镳,它们合入安全补丁的速度往往比公有云厂商还要慢上好几拍,甚至干脆瞒报不修,假装无事发生。
其次,退一步讲,哪怕是完全从零手搓的纯闭源商业软件,就能躲过 AI 的猎杀吗?别天真了。只要是人类程序员写的 C / C++,只要经过现代编译器编译成机器码,它的内存分配、边界检查、协议解析就会呈现出高度一致的 Pattern(模式)。现在的 AI 早就进化到可以直接配合 IDA、Ghidra 等反编译工具,对着没有符号表的二进制文件做逆向分析和定向 Fuzzing(模糊测试)了。
更关键的是认知上的因果倒置。开源软件有人盯着找 Bug、提修复,到底是坏事还是好事?从软件工程的终极规律看,这是天大的好事。
要明白一个基本事实:只要不盲目堆砌花哨的新功能、不乱改底层架构,一个成熟系统里的 Bug 总量是有限的。 为什么 PG 19 宁可打破多年的发版传统、罕见延期并砍掉一堆已写好代码的新特性?部分原因正是社区极其清醒——先把新功能停一停,尽量把存量地雷排掉。
在一个功能收敛的稳定分支上,在不引入新缺陷的前提下,Bug 可以看作“不可再生资源”——被 AI 扫出来一个、正确修掉一个,系统里潜伏的雷就少一个,稳定分支就有机会越来越安全。 现在的 Linux 和 PostgreSQL,实际上正在经历人类软件史上最残酷、最高强度的“AI 集体渡劫”:全世界最顶尖的安全研究员拿着最先进的算力,免费帮开源基建做地毯式排雷。
而闭源商业软件呢?平时源码藏着掖着,既没有成千上万双眼睛帮它做代码审计,也没经历过公开的攻防毒打,积累的实战免疫经验少得可怜。那不是“没有漏洞”,那只是“没人帮它排雷”而已。黑盒里往往堆积着大量极其低级、连静态检查都过不了的脆弱实现。平时看着岁月静好,一旦哪天源码泄露,或被黑客挂上二进制 AI 审计工具重点照顾,根本没有纵深防御可言,大概率会被当场“一波捅穿”。
所以千万别搞错因果:错的从来不是“开源与透明”,而是“在公网多租户环境里裸奔”。 开源软件现在的痛点,仅仅在于“漏洞公开修复”到“补丁落地生效”之间存在一个时间差窗口。既然我们既想要开源软件被千锤百炼后的极致安全,又不想在这个窗口里当公网上的活靶子,该怎么解这个死局?
答案其实很简单:用“空间上的物理隔离”,去切断攻击者利用“时间上的补丁窗口”的远程通路。
三、刻光盘进机房的岁月
老冯一直是 “本地优先(Local-First)”运动与数据自主(Data Autonomy) 的坚定倡导者。很多用过 Pigsty 的朋友知道,Pigsty 从诞生的第一天起就支持“离线安装”,一个基本工作假设就是:互联网不存在。
为什么会有这个设计基因?因为当年的第一个客户就是涉密部门。进人家的核心机房,别说拉公网下个 Docker 镜像或者 yum install 了,那里面是真正的物理断网,连根网线都不通外面的世界。那时候怎么装数据库?我们必须把操作系统依赖、数据库源码包、监控组件、甚至每一个细碎的 RPM 依赖包,全部打包做成一个完全自给自足的离线安装源,然后老老实实刻成 DVD 光盘,揣着光盘进机房,插进服务器光驱里读出来安装。
当年干这活的时候,老冯也觉得真不方便。但经历这几年云安全的魔幻现实,尤其是看到最近这波排山倒海的漏洞海啸,我越来越深刻地理解并敬畏这种利弊权衡:物理隔离,就是人类信息安全史上最简单、最粗暴、也最有效的终极防线。
你在云上可以画最漂亮的架构图,讲各种高大上的“零信任”、细粒度 IAM、eBPF 沙箱、SOC 2 合规认证。但你改变不了一个残酷事实:只要你的机器连着公网,或跟别人的实例共享底层基础设施,一个配置缺陷、一个泄露的工单 Token、或一个刚在 GitHub 上提交的 C 语言内存溢出,就能让地球另一端的脚本小子在几秒内把你一锅端。
但如果你做到了真正的物理隔离(Air-Gap),攻击者的成本会怎样变化?网线那头的脚本和 AI 统统失效了。攻击者得想办法把恶意代码带进内网,走供应链、移动介质或者内部人员这类路径。想想当年针对伊朗纳坦兹铀浓缩设施的“震网(Stuxnet)”:目标不直接连公网,也不等于完全无法触达。
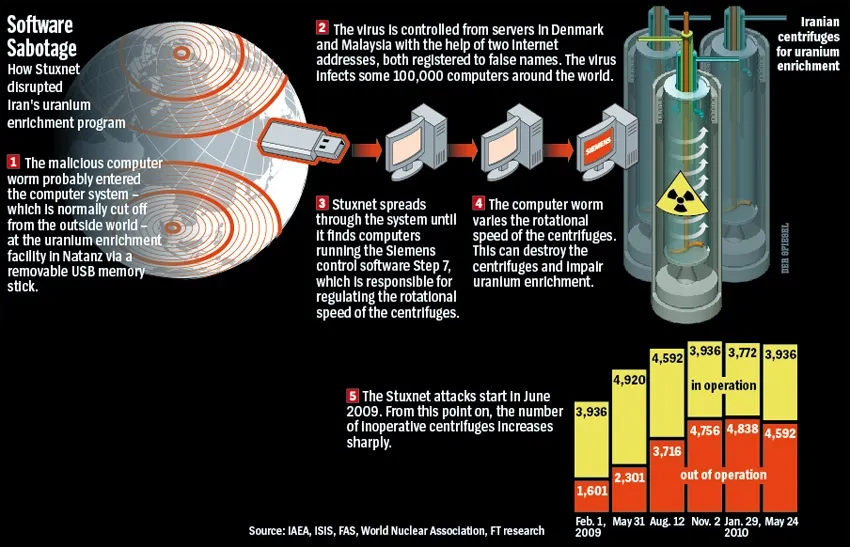
或者搞真正的“物理渗透”:半夜潜进你们公司大楼,接触内网设备,或者偷走办公电脑解密;再不然,就只能祭出密码学界最闻风丧胆的“橡胶软管密码分析(Rubber-hose cryptanalysis)”——也就是俗称的“五美元扳手攻击”:直接绑架你们公司的 DBA,拿把大扳手严刑拷打,逼他说出密码。
物理隔离虽然不能让安全变成绝对的 100%,但它直接把攻击门槛从“脚本小子敲回车”,强行拉高到了“好莱坞谍战片 + 恶性刑事犯罪”的级别。这就是为什么这些年老冯见过太多物理隔离的内网环境,里面 Linux 内核和数据库三五年根本不升级,跑着七八年前的老版本、不打补丁,运维人员心态稳如老狗,而且在老冯见过的那些场景里,确实长期相安无事。
因为物理隔离与独占硬件,能把互联网上陌生人的恶意 SQL、恶邻容器和虚拟机挡在外面——许多远程攻击路径,在进入软件层之前,就已经在物理网络层面被切断了。 内网中的不可信账号、被攻陷的应用和供应链仍然要管,隔离也不意味着补丁可以永远不打;但攻击者要走到软件漏洞面前,已经难了太多。
当然,退一步说,就算你做不到物理隔离,在主机与数据库外围,你依然可以靠一道正确配置的防火墙与内网边界极大收窄攻击面。不幸的是,云端很多事故,恰恰出在“没有能力做正确配置”上——Supabase 那 1.6 万个裸奔的库就是活生生的例子。
四、《赛博朋克 2077》的预言:退回“黑墙”之内
我们也许正在见证一个历史性的拐点。
过去十年,云计算厂商用“规模经济”和“专业团队帮你管安全”的叙事,把无数企业的核心数据哄上了多租户的公有云。但现在,AI 算力的爆发正在把漏洞挖掘从“手工作坊”变成“工业流水线”。当漏洞发现的速度远远超过云厂商打补丁的速度时,公有云引以为傲的规模效应,瞬间反噬成了“单点突破、全网连坐”的巨大靶场。
这会从根本上逆转 云服务 与 本地自建(Self-Hosted)、本地优先(Local-First) 之间的力量对比。
写到这儿,老冯脑海里浮现的是游戏《赛博朋克 2077》的世界观设定:
在它的背景历史里,传奇黑客巴特莫斯释放了“数据崩溃(DataKrash)”病毒,无数失控的流窜 AI 在旧公网上大杀四方,把原本互联互通的全球网络变成了谁连上去谁就被瞬间烧穿脑机接口的死亡禁区。最终,人类不得不依靠“黑墙(Blackwall)”把失控的旧网隔在外面,退回受到保护的网络空间。这道游戏里的 AI 屏障,当然不等于现实中的物理断网;但“把危险的外部世界隔开”这个意象,实在太贴切了。
看看今天互联网上日夜不停扫荡端口的自动化脚本,看看正不知疲倦审计开源 C 代码库的 AI 模型,再看看接二连三被捅成筛子的云厂商。《赛博朋克 2077》真的只是科幻游戏吗?我觉得现在简直是在踩着油门往那个方向狂奔。
当然,老冯肯定不是提倡让所有用户明天就断网——那不现实。真正的解法是分级:把最核心、最敏感的数据拿回自己手里、退回内网、筑起物理隔离的高墙;其余业务,至少也要把防火墙配对、把攻击面收窄。
因为在流窜 AI 与自动化漏洞横行的荒原上,也许只有那块断了网的领地,才是真正的安全区。