无嘴模型:AI 的 OLTP 时刻

半夜三点,一条告警:复制延迟 187 秒,持续七分钟,生产集群,两个从库都活着。该不该把值班 DBA 叫醒?
这是一个 bit 的问题。
交给今天最聪明的大模型,它会先写三百字——复述指标、分析原因、权衡误报——最后吐一段 JSON:{"page": true}。两秒,几块钱。答案占一个字节,剩下几千个 token 是包装。
复杂事故值得这么想。但每一条工单、每一次路由、每一步工具调用都走这一套,就不对了。大量判断只要一个很短的答案,我们却给它套上了长篇生成的外壳。
9 月 15 日,一家叫 TypeSafe 的公司发布了 Jev,拿了 DCVC 领投的四千万美元种子轮。这个模型不会说话。你给它一段状态和一组题——这是哪类故障(选择题)、几级严重(评分题)、要不要现在叫人(判断题)——它一次把所有题的概率分布吐回来,70 到 500 毫秒,输入 0.042 美元一百万 token,输出免费,因为压根没有输出 token。它不写作文,不生成代码,不解释自己, 只做一件事:看一眼,给每个选项一个概率。
第一反应:这不是残废吗。第二反应:这才是干活的形态。
先说清楚,这篇不是 Jev 的评测。它发布才几天,还在内测,自家公布的跑分六成八,我不会把一篇文章押在一家创业公司身上。它值得写,是因为它把一件早就存在、一直没人当回事的东西摆到了台面上。这篇文章回答三个问题:这东西到底是什么,它值多少钱,它该放在软件的哪一层。**三个问题的答案合起来是一句话:
过去几年,我们一直在用 OLAP 的引擎跑 OLTP 的活。**
上篇 · 它是什么
一、用作文回答判断题
程序里绝大多数需要“智能”的地方,不需要一篇文章。这条工单归哪个部门、这条日志是不是异常、这段输入有没有注入、这个候选文档相关不相关、Agent 要执行的这个操作危险不危险——全是选择题、判断题、评分题,答案空间事先就知道,要的就是几个 bit。
可今天要从大模型手里拿到这几个 bit,流程是:写 prompt,让它推理,让它生成一段合 schema 的 JSON,解析,校验,失败重试,再从 JSON 里把字段抠出来。一个 bit 穿着两千 token 的马甲。
公平地说,没有谁规定判断题必须先写作文。关掉推理、限制输出、直接读候选 token 的概率,都能省掉大量开销,后面我会拿它当基线来比。问题在于主流的产品和工具链仍然习惯从“生成一段文本”出发,再把文本改造成程序需要的返回值。
为什么?因为大模型从一开始就是造出来跟人说话的。ChatGPT 是 2022 年 11 月的一个产品决定,在那之前 GPT-3 只是一个补全接口,没人觉得 AI 非得是聊天框。那个聊天框太成功, 把整个行业锁死在“AI 等于说话”上。之后几年的后训练都在服务两个客户:RLHF 服务人,让模型说得让人舒服;RLVR 服务判题器,用可验证的奖励教模型推理。
一直没人认真服务第三个客户:程序。
程序不需要模型说得舒服,也不需要它把推理过程写出来。程序要的是一个类型安全的返回值,加一个“你有多确定”。它想调用一个函数,拿到的却是一篇散文, 还得自己去散文里找返回值。Structured Outputs 解决了一半——JSON 一定合法了——但你还是在让模型“写”一段格式规范的作文,作文再短,也是一个字一个字写出来的。
问题的根子就在“一个字一个字”上。
二、嘴是怎么缝上的
学神经网络的人第一课都是 MNIST:给一张手写数字,判断是 0 到 9 里的哪个。网络最后一层是十个神经元,过一个 softmax,输出十个加起来等于一的数——是 0 的概率、是 1 的概率……取最大的那个就是答案。从 1998 年的 LeNet 到今天每一份入门教程都是这么干的。它不会说话,也没人觉得它需要说话。没有人提议让它生成一句 “The digit appears to be a seven”,然后再用正则把 7 抠出来。
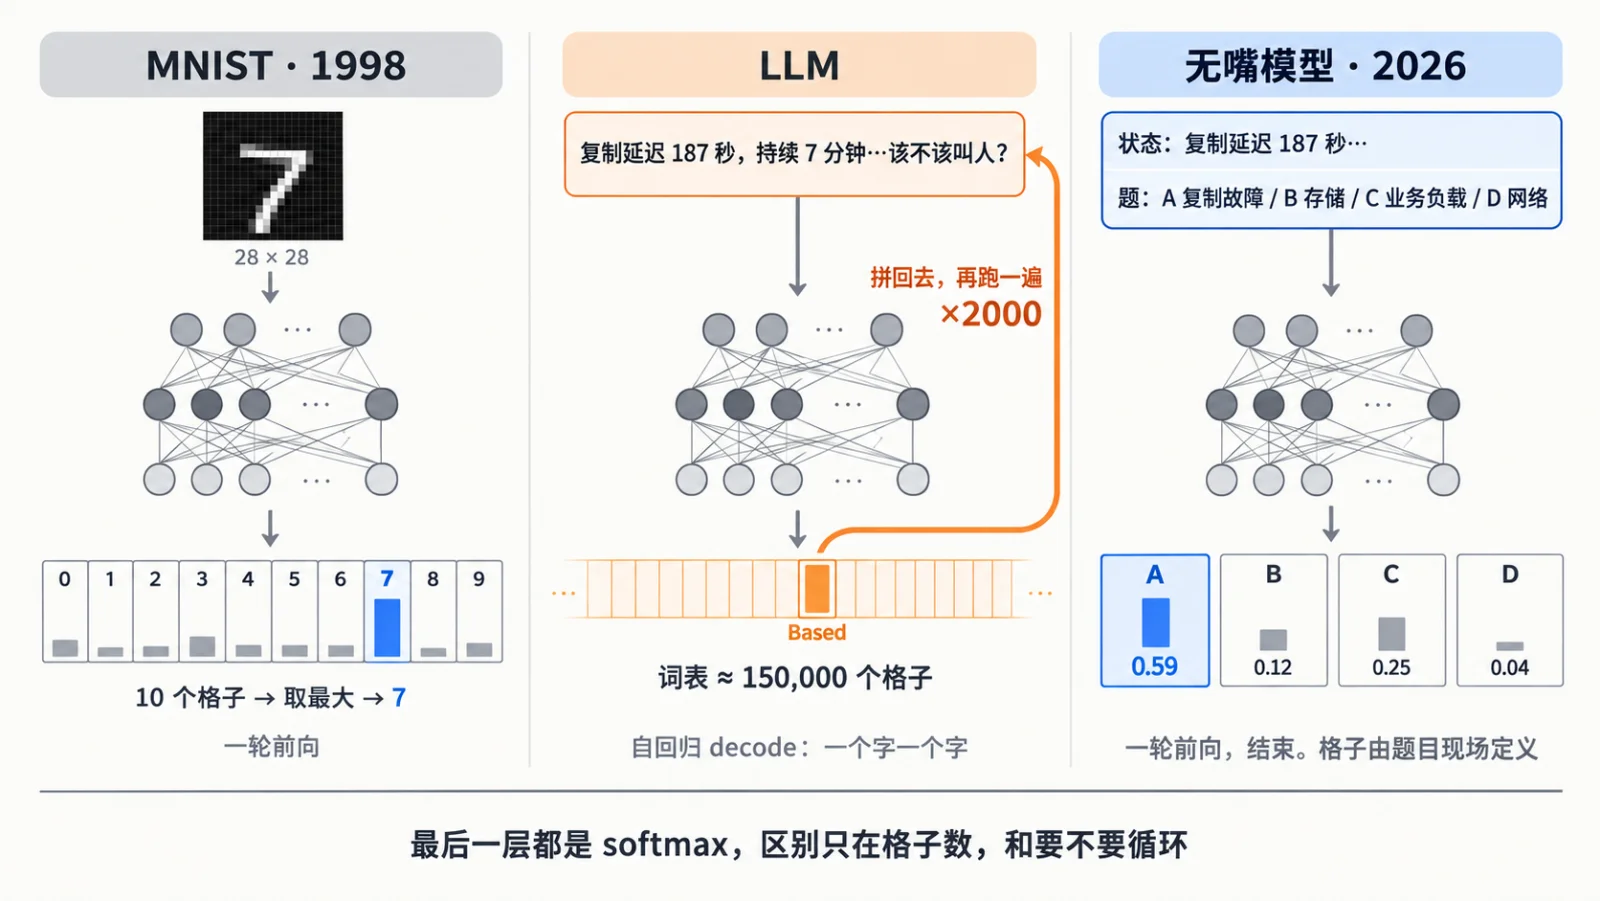
大语言模型的末端是同一个结构:最后一层也是 softmax,也是一组加起来等于一的概率。只是格子从十个变成十几万个——词表里每个 token 一格。每跑一次前向, 它给出“下一个字是什么”的分布。正常生成是从分布里挑一个字,拼到句尾,把整句送回去再跑一遍,再挑一个。一个字一个字往外挤。这叫自回归 decode, 两千字的回答是两千轮前向,每轮等上一轮。
那如果压根不要它说话呢?把题写成“下面哪个对:A 复制故障 / B 存储 / C 业务负载 / D 网络”,在该出答案的位置,直接把 A、B、C、D 四个格子的概率读出来。一轮前向,结束。
这事一点不新。2020 年 MMLU 出来之后,学术界评测大模型做选择题用的就是这个办法:读那个位置上 A/B/C/D 的 logprob,谁大选谁。Qwen3-Reranker 的官方示例直接取前向结果里 yes 和 no 的 logit 归一化成分数,从头到尾没调用过生成。跑评测的人早就知道,模型肚子里那个 MNIST 式的分类器一直在,只是没人把它当产品卖。
那 Jev 到底做了什么?
不是“输出概率分布”。分类器从 1998 年起就一直输出概率分布;广告点击率模型、风控模型、垃圾邮件过滤器,几十年来都在请求链路里毫秒级吐概率。新的地方是:MNIST 的十个格子是训练时钉死的,Jev 的格子是你调用时用自然语言现场定义的。 想判断什么、选项有哪些,写在请求里就行,不用为每道题攒数据集、训模型。背后撑着的是大模型读过的整个世界。一个分类器,题目随便换。
在这基础上它做了三处工程活。第一,把 token 的分布收成选项的分布——普通模型的概率会散在 “Yes”、“ yes”、“Y”、“Based on” 一堆 token 上,Jev 的输出头直接对应你给的选项, 五个候选五个格子;选择题上限 255 个,我猜就是一个字节的索引。第二,换训练目标——普通模型那个位置的概率从没被训练成“我答对的概率”,RLHF 之后校准还会变差;Jev 的目标是“对给定选项集输出一个校准过的分布”,他们叫 RLCD,Reinforcement Learning for Calibrated Decisions,目标是让 0.9 真的意味着十次里对九次。第三, 多问题并行——同一段状态编码一遍,十几个问题各挂一个短尾巴,彼此屏蔽,各读自己那格,多问一题边际成本接近零。
以前,这些能力跟着一个业务、一份数据集、一支机器学习团队走。现在它有机会变成普通程序员随手调用的通用零件。机制是旧的,改变软件的是交付形态。
打个比方:还是那个大脑,把嘴缝上,额头装一块压力表。题摆到它面前,读完那一刻,压力表就指到某个刻度。它不能告诉你为什么,也不能多想一会儿,看一眼知道多少就是多少。
这也是它的天花板。答案只有一个 bit,不代表算出这个 bit 只要一点脑子。“这段证明对不对”“这次切主安不安全”都能用是或否回答,却可能需要大量分析。没有思维链, 凡是要多步推导的结论,它不如一个带 CoT 的小模型;凡是“看一眼就知道”的题,它接近最强的模型。
还有一条实操:给题目留一个出口,“其他”“信息不足”“需要进一步分析”。真实答案漏在选项之外,模型再类型安全,也只能在错误的世界里分配概率。
三、直觉是第零次革命,为什么是现在
我们习惯把这几年讲成“聊天 → 推理 → Agent”,然后猜下一步。按这个叙事,“直觉”要算革命该排第三第四。
但回头看机制。GPT-3 是什么?没有思维链,没有推理步骤,看一眼上文蹦一个字。用卡尼曼的话说就是 System 1:快,自动,不解释。2022 年思维链、2024 年 o1, 做的都是往这台直觉机上焊 System 2——先把中间步骤写出来,拿自己的输出当草稿纸。顺序其实是:直觉 → 聊天 → 推理 → Agent → 现在回头把一直被扔掉的第一轮直觉单独拿出来卖。
直觉不是第三次革命,它是第零次。
System 1 和 System 2 在这里是比喻,不是机制——一次前向也是几十层计算,不是灵光一闪。但比喻抓住了三个真实特征:一步出结果,不能多想,不解释。分界线在任务需不需要额外的计算过程,跟回答有几个字无关。
司马贺 1992 年有一句话是理解这类模型最好的钥匙:直觉,无非就是识别。 象棋大师看一眼棋盘就知道走哪,不是算得快,是见过五万个类似局面,这个局面被认出来了。识别的前提是答案在一个已知的集合里。这恰好划出无嘴模型的边界:选项已知的用它——分类、路由、打分、门控、排序、校验;选项未知的——写一段没人写过的代码、想一个新方案、解释一个没见过的故障——还得让模型开口,因为那是搜索,不是识别。
顺便交代一句,免得跟我上一篇打架。《两个半球》里我押的右脑是 Diffusion,是生成式的直觉,看一眼就“看出”该往哪走;Jev 是判别式的直觉,你把选项摆好,它告诉你哪个像。用 AlphaGo 的话说一个是 policy network,一个是 value network。大师两样都有,Jev 只做了后一样。
既然读 logit 早就能做,为什么到今天才成为一个“时刻”?三个条件刚凑齐。需求侧,Agent 把软件里的一眼题从每天几千道变成了每秒几千道,而且出现在以前没有分类器的地方, 每一步工具调用前后都有“对不对、完没完、相关不相关”,这是编程史上第一次出现海量的、机器发起的、只要一个 bit 的问题。供给侧, 几 B 到十几 B 的模型在判断类任务上追到了 frontier 的九成,而这个尺寸能在一台工作站甚至笔记本上一百毫秒跑完。最后,有人开始专门训练“知道自己有多确定”。三件事凑齐之前, 读 logit 是评测技巧;凑齐之后,它是一层基础设施。
中篇 · 它值多少
四、搬砖:为什么它快、为什么输出免费
这一节讲一点体系结构,我尽量说人话。
想象 GPU 是一个工人,模型权重是一仓库的砖。每次干活他得把整仓库的砖搬到工位上。
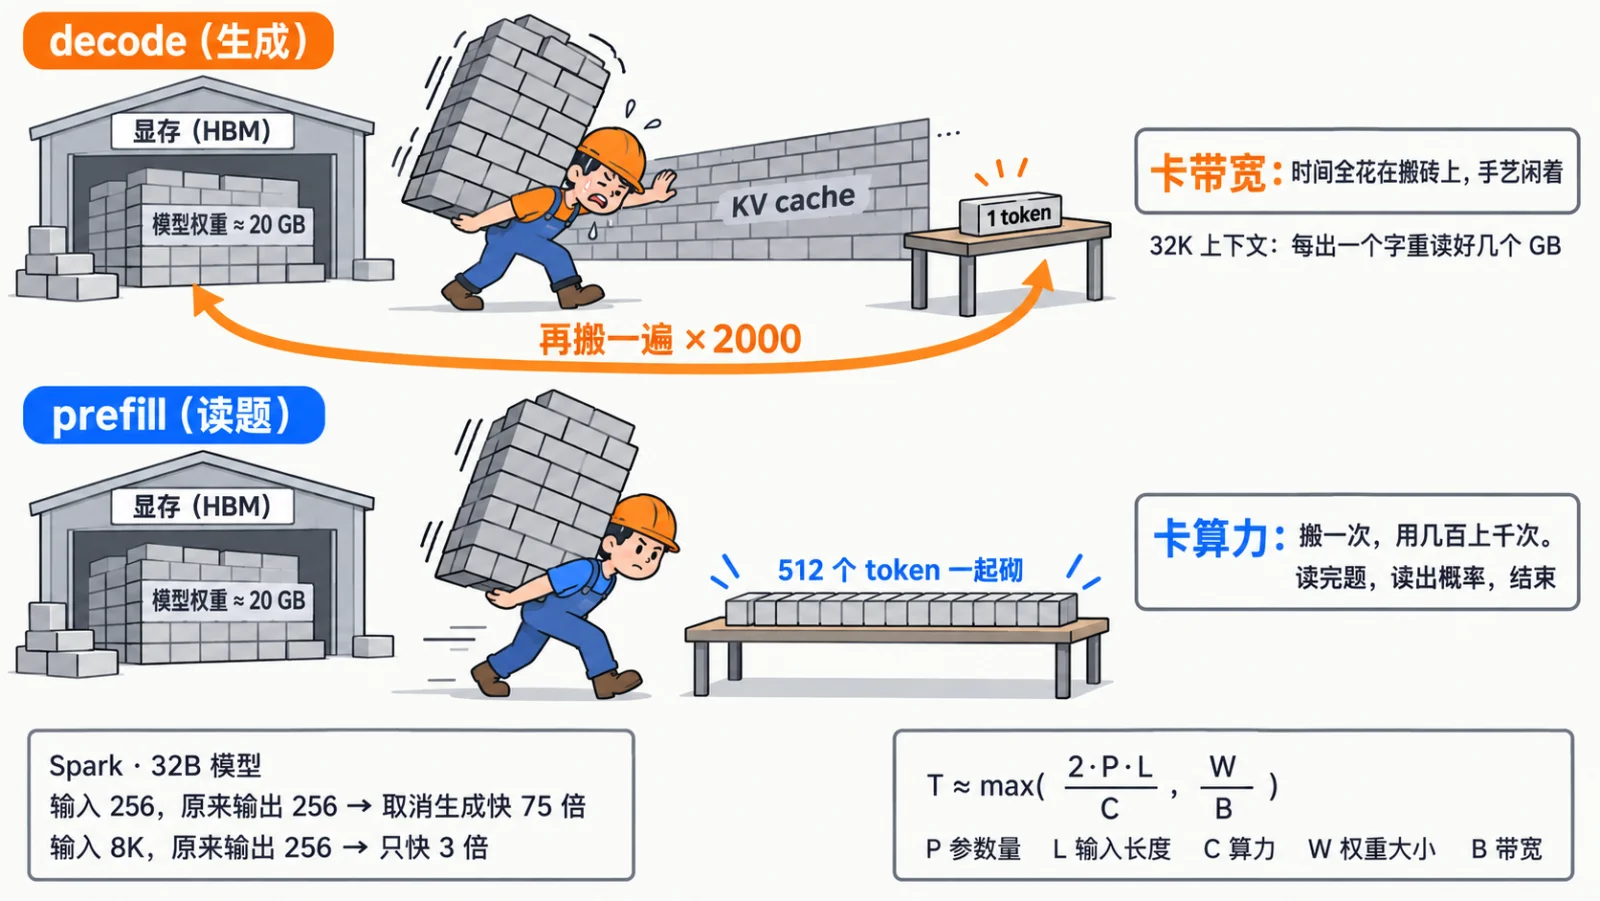
decode 的时候,他每搬一遍砖只砌一块——生成一个 token——然后再搬一遍,再砌一块。时间全花在搬砖上,砌墙的手艺基本闲着。这就是为什么单请求出字时 H100 绝大部分算力在发呆, 全在等显存把权重喂过来,行话叫“卡带宽”,也是推理卡必须配 HBM 的原因——HBM 就是搬砖特别快的传送带,显卡上最贵的物料之一。decode 还有一笔更狠的账:每砌一块, 还得把之前砌好的墙——KV cache——重新摸一遍。32K 上下文出一个字要读好几个 GB,这才是长上下文 decode 真正的杀手。
prefill 的时候——把输入读一遍——他搬一遍砖能砌一整排,输入有多少 token 就砌多少块。砖搬一次用几百上千次,搬砖不再是瓶颈,手艺才是。行话叫“卡算力”,意思是 GPU 终于在干活而不是在等内存。
无嘴模型只做 prefill。读完题,读出概率,结束。没有 decode 循环,没有 KV cache 重读,没有输出 token。它把 AI 从带宽游戏拉回了算力游戏。行业早承认这两种负载是两种生物——Kimi 的 Mooncake、学术界的 DistServe 都在做 PD 分离,prefill 和 decode 跑在不同机器上。无嘴模型等于说:我只要 prefill 节点。
两个限定必须老实写。一,“卡带宽”是低 batch 才成立的:吞吐型服务把几百个请求攒一批一起出字,工人一次搬砖砌几百块,也就不卡了。无嘴模型的优势是不用攒——单个请求自己带着几百上千 token 的并行度,一个人就能把 GPU 吃满,所以它的红利在延迟上:一百毫秒的同步调用,等不了凑单。二, 带宽也不会从此没用——输入很短、模型很大、实现不好的时候照样卡;宏观上 HBM 的需求更不会跌,训练和 Agent 的长 decode 还是大头。准确的说法是: 这一类负载不需要 HBM,可以下沉到便宜的硬件层。
能快多少,取决于输入多长、原来要输出多长。用一台 DGX Spark、一个 32B 模型算:输入 256 token、原来输出 256 token,取消生成快 75 倍;输入 1K,快 20 倍;输入 8K,只快 3 倍。输入短、原来输出长,收益最大;输入很长、原来输出很短,收益很小。而如果原来就只输出一个标签,普通 LLM 读单个 token 的 logit 已经拿到了大部分加速——这一点后面还要回来说。
拆一下官方那个“便宜四百倍”:模型小,10 到 20 倍——从价格反推它大概是一个一二十 B 激活的模型,这是我的估算;没有输出 token,5 到 20 倍——输出本来就比输入贵好几倍, 还要加思考过程;一段状态编码一次问十几个问题,边际接近零。三样乘起来两个数量级,不需要魔法。最要紧的是最后一样:成本主要花在读一遍 state 上,多问一个问题几乎不加钱。
五、OLTP 时刻
做了十几年数据库,我看什么都像数据库。但这回我觉得这个类比不是职业病。
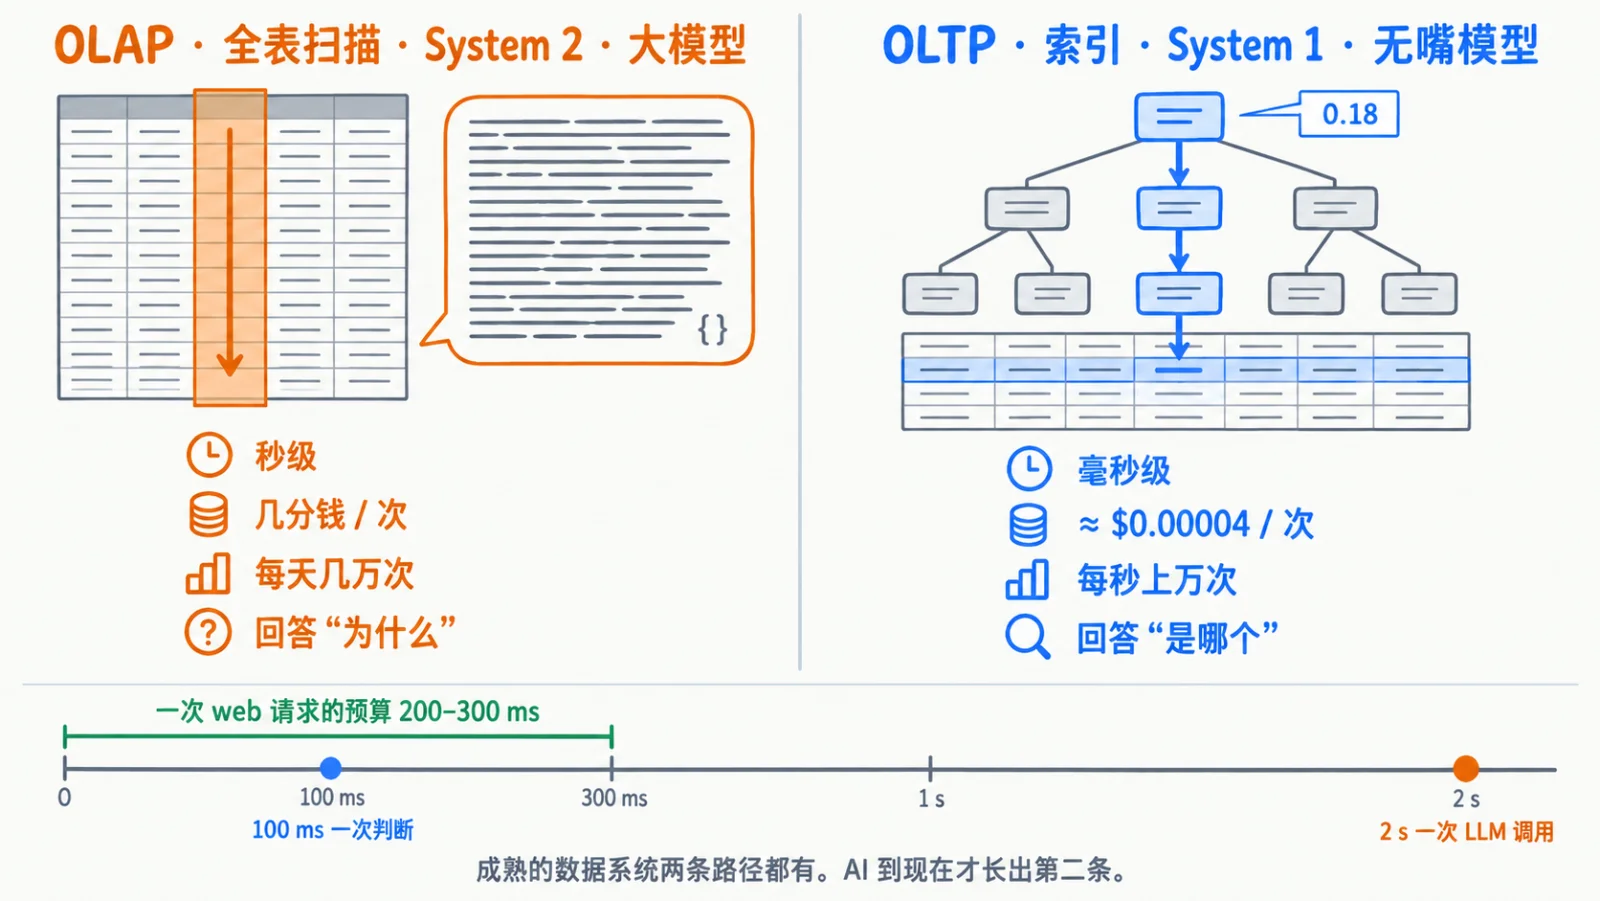
数据库有两种访问模式,从根上就不一样。点查:按主键取一行,走索引,毫秒级,每秒几十万次。扫描:整表读一遍算个聚合,秒到小时,一天几十个。前者叫 OLTP,后者叫 OLAP。两种模式要的机制完全不同——索引结构、缓存策略、执行路径、硬件配比——可以放两个系统里,也可以像 PostgreSQL 这样放一个引擎里用两条路径伺候。但没人会拿全表扫描回答每一次用户登录。(严格说 OLTP 的核心是事务不只是快,我借这个词借的是访问模式:短、频、快、并发高。)
过去几年,大模型一直是 OLAP。重、慢、贵,一次几秒几分钱,一天跑不了几万次。它做的事本质上也是全表扫描:把整个上下文读一遍,把推理过程写一遍,把结论从头推到尾。这个能力当然了不起,就像分析型引擎能在 PB 数据上回答任何问题一样了不起。但你不会用它承接每一次点击。
无嘴模型是 AI 的 OLTP。点查,毫秒级,便宜到随手调。它不回答“为什么”,回答“是哪个”;不做扫描,做识别。用数据库的话说:System 2 是全表扫描,System 1 是走索引。 索引是把“这行在哪”的答案提前算好存着,直觉是把“这种局面该怎么办”提前压进权重里。任何成熟的数据系统都同时需要这两条路径,AI 到现在才长出第二条。
OLTP 当年真正改变的不是报表变快,而是一整类应用得以存在:在线交易、实时库存、网上银行。共同点是把数据库放进了请求链路——用户点一下,几十毫秒内必须给答案。分析型引擎再强也做不了,因为不在那个延迟量级。一个 web 请求的预算两三百毫秒,两秒的 LLM 调用永远进不了这个链路,所以今天大模型在软件里的位置基本是异步的:后台 Agent、批处理标注、用户等着看的聊天框。专用小分类器倒是一直在链路里,但每一个都得单独训。一百毫秒、题目现场定义的通用判断,可以同步调用, 可以放进一次 HTTP 请求,可以挂在一个数据库触发器后面。
这不是快了一个数量级,是换了一个可以存在的位置。
OLTP 这个类比还带来两样东西。一是可预估。一次生成的耗时取决于它想说多长,没法给 SLO;一次判断的耗时是 max(2PL/C, W/B)——模型定了、输入长度定了,延迟就是一个能算出来的数,
像索引查找是 O(log n) 个页面而不是“看情况”;公式不是 SLO,排队、网络照样影响尾延迟,但至少有了预算的基础。可预估才能进请求链路、做准入控制、按调用计价。二是纪律。前面那组数说的其实就是 OLTP 纪律:行要短,查询要点查,别在事务里扫全表——state 要精炼,选项要固定,问题要原子,超时要有退路。把几十页日志塞进去要求一眼判断,就是在 OLTP 库里跑报表。
六、本地硬件:这次是真的
OLTP 的另一个含义是:它跑在你自己的机器上。
我让几个模型帮我估了一遍本地设备在“只做判断”这种负载下的表现。口径统一:512 token 输入、稠密模型、4-bit 量化、单请求、权重常驻。其中 Spark 有公开的 llama.cpp 测试做锚点——Qwen3 8B 读 512 token 约 162 毫秒,32B 约 672 毫秒——其余是按同一模型的估算,不是端到端实测。
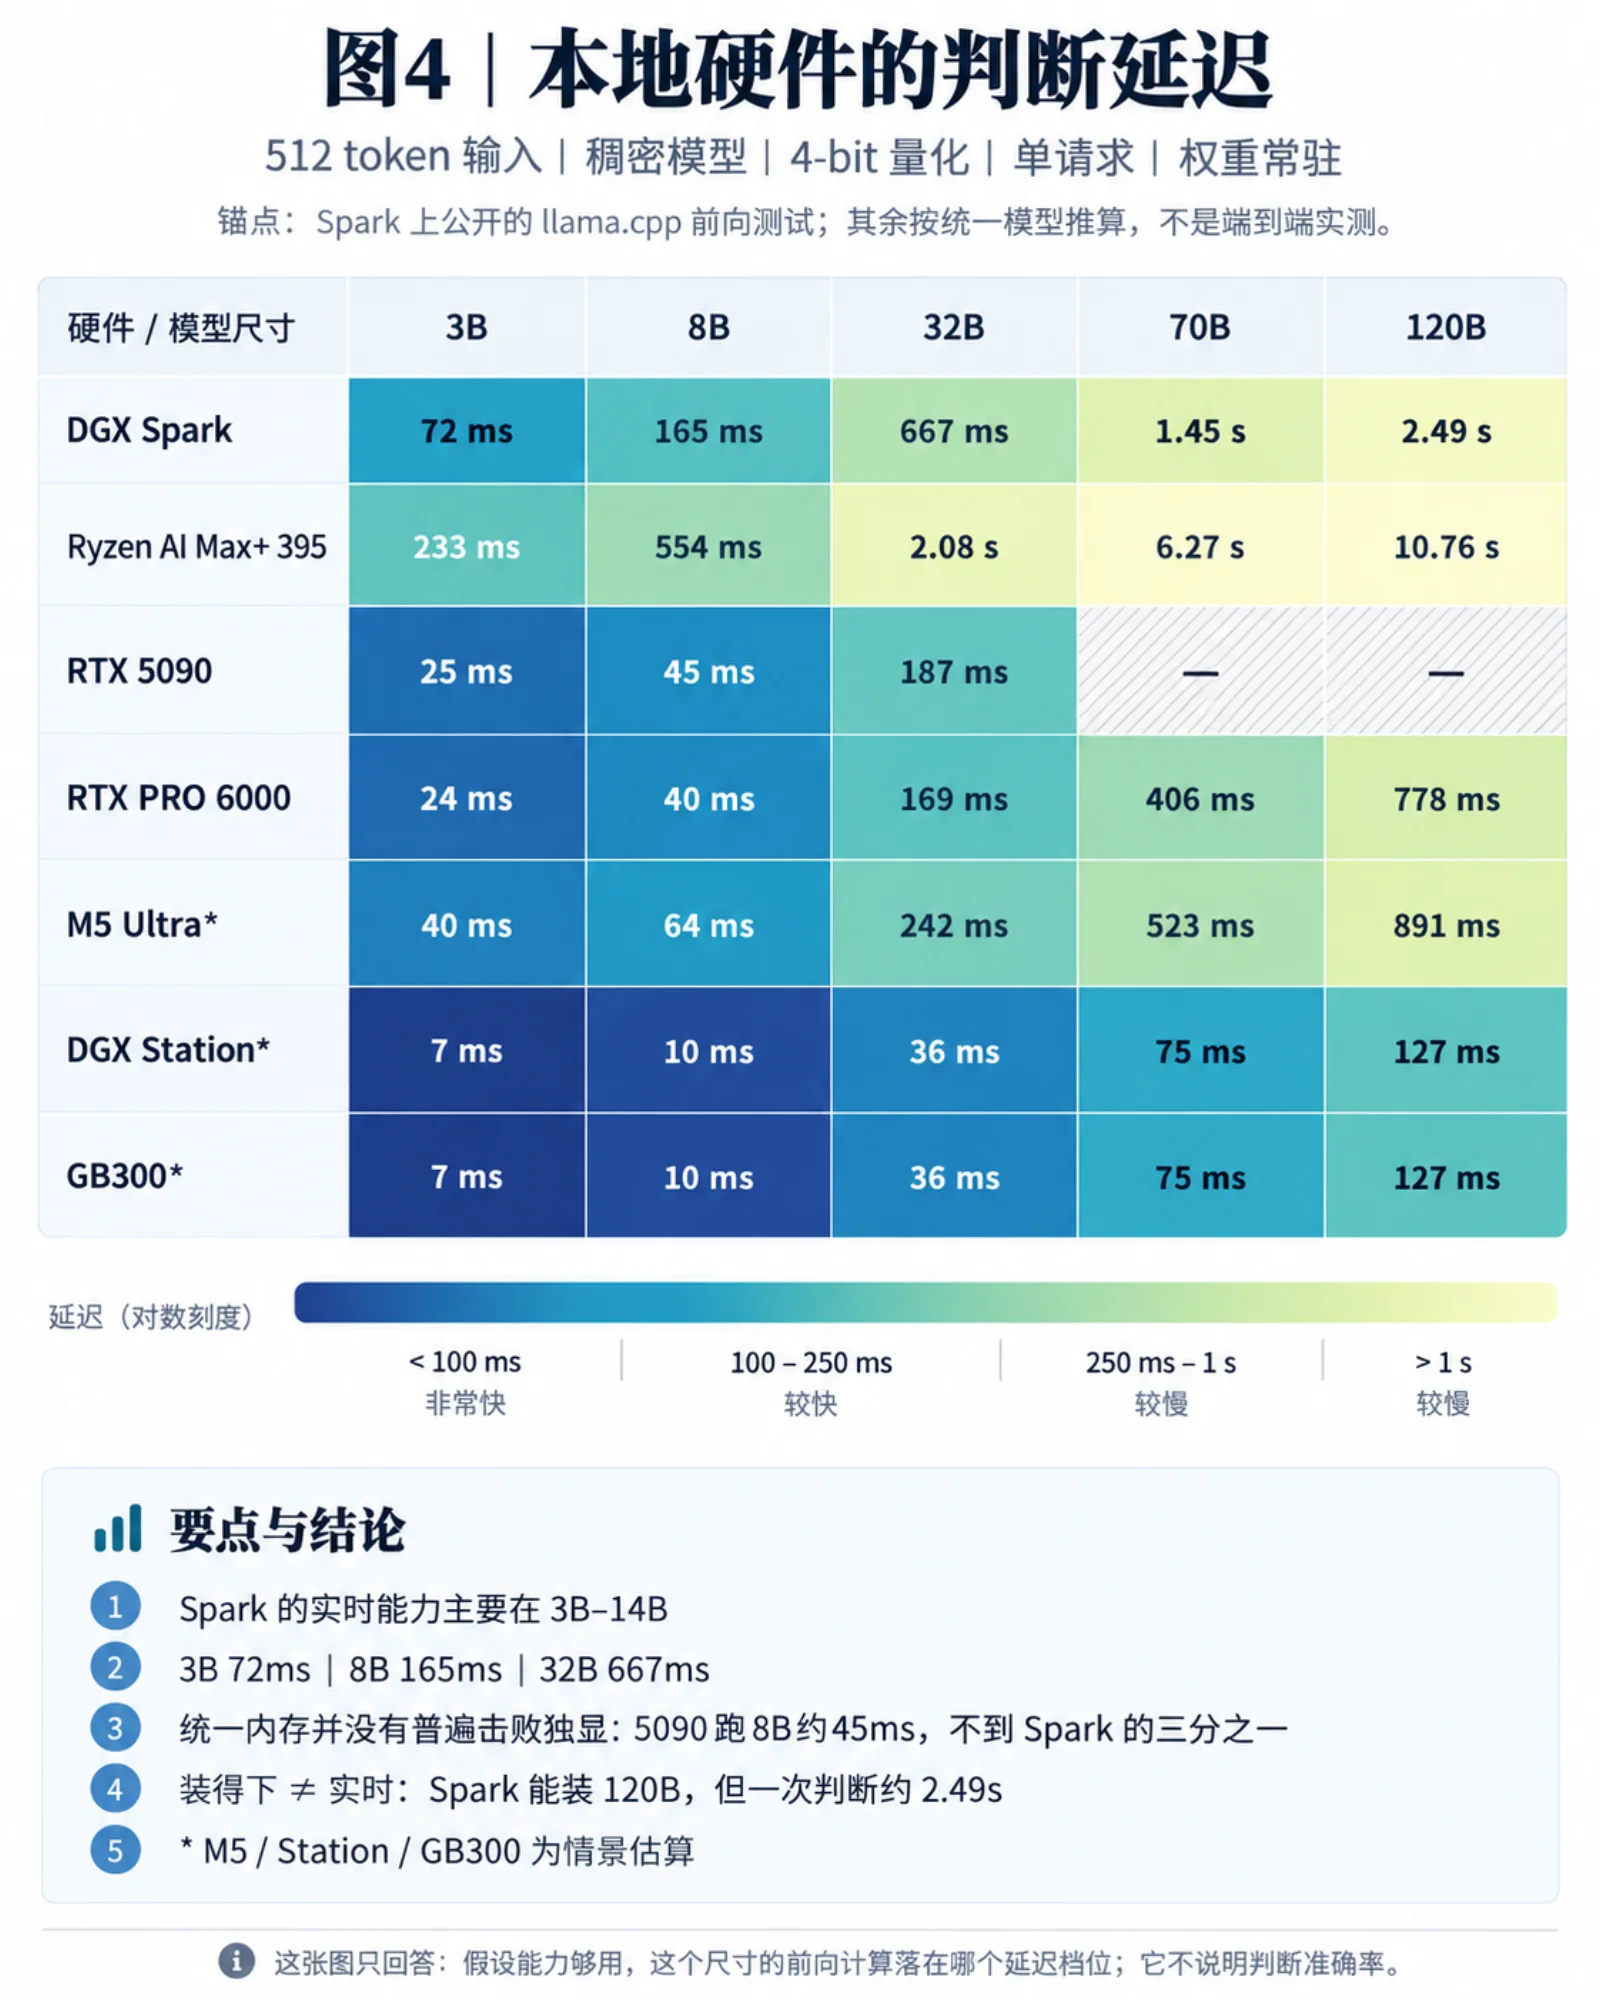
| 硬件 | 3B | 8B | 32B | 70B |
|---|---|---|---|---|
| DGX Spark(128 GB LPDDR5X,273 GB/s) | 72 ms | 165 ms | 667 ms | 1.45 s |
| Ryzen AI Max+ 395 | 233 ms | 554 ms | 2.08 s | 6.27 s |
| RTX 5090(32 GB) | 25 ms | 45 ms | 187 ms | 装不下 |
| RTX PRO 6000(96 GB) | 24 ms | 40 ms | 169 ms | 406 ms |
这张表说了三件事。
第一,装得下多大的模型,和能实时用多大的模型,差距很大。 Spark 能装 120B,但一次判断两秒半,不能因为只返回一个概率就叫它“实时反射”。它的实时能力集中在 3B 到十几 B:3B 几十毫秒,8B 一两百毫秒,32B 亚秒级。这已经够支撑告警分诊、工单路由、候选操作检查这类后台判断——前提是这个尺寸的模型判断质量过关。
第二,大统一内存没有普遍击败独立 GPU。 模型装得下时,有效矩阵算力依然是王:5090 跑 8B 只要 45 毫秒,不到 Spark 的三分之一。5090 的限制是容量,PRO 6000 把容量边界往外推,70B 也能进半秒。Spark 的价值是容量、形态、功耗约束下的可用性,不是性价比第一。
第三,压缩状态往往比换更大的模型更重要。 256 token 的结构化摘要和几千 token 的原始日志不是同一个性能问题。先让确定性程序把关键指标、变更、证据汇总好,再交给模型判断, 比每次把整个监控世界重新塞进去值得得多。
还有一个反直觉的发现:批处理在这里帮不上什么忙。Spark 上 32B 从 batch=1 到 batch=16,吞吐只涨 16%,每个请求的等待却从 0.67 秒变成 9.2 秒。因为 prefill 本来就把算力吃满了,
攒批只是在加总计算量。所以直觉型服务最该看的指标不是峰值 QPS,是响应预算内每秒能完成多少判断。
为什么本地在判断这件事上比在聊天上有戏得多?五个理由。小模型和大模型的差距在判断上远小于在生成上——本地跑 Llama 聊天一直是玩具,因为开放式生成的质量差距肉眼可见, 判断恰好是差距最小的地方。控制流不能跨洋——如果程序里每个 if 的判断权来自一家美国公司的 API,它一挂你的分支语句就停了。状态里的东西不能出门——日志、邮件、屏幕内容、指标, 判断要看的恰恰是最敏感的。账算得过来——按标价每秒 10 次、每次 1K token,一个月 1,088 美元,一台 4,699 美元的 Spark 四五个月回本;持续监控类负载只有本地才成立。最后,个体化只能在本地长——这一条后面讲。
苹果其实已经把这套架构造出来了:端侧模型,不够用升级到 Private Cloud Compute,再不够经用户许可才上第三方模型。三级级联,按需升级,隐私边界清楚,只差把概率做成一等公民。所以本地 AI 的叙事会从“在家跑 Llama”转向“在家跑你的判断器”。语音和相机之后,第一个真正大众化的端侧 AI 负载,很可能是持续判断。
下篇 · 它放在哪
七、层级里的新一层
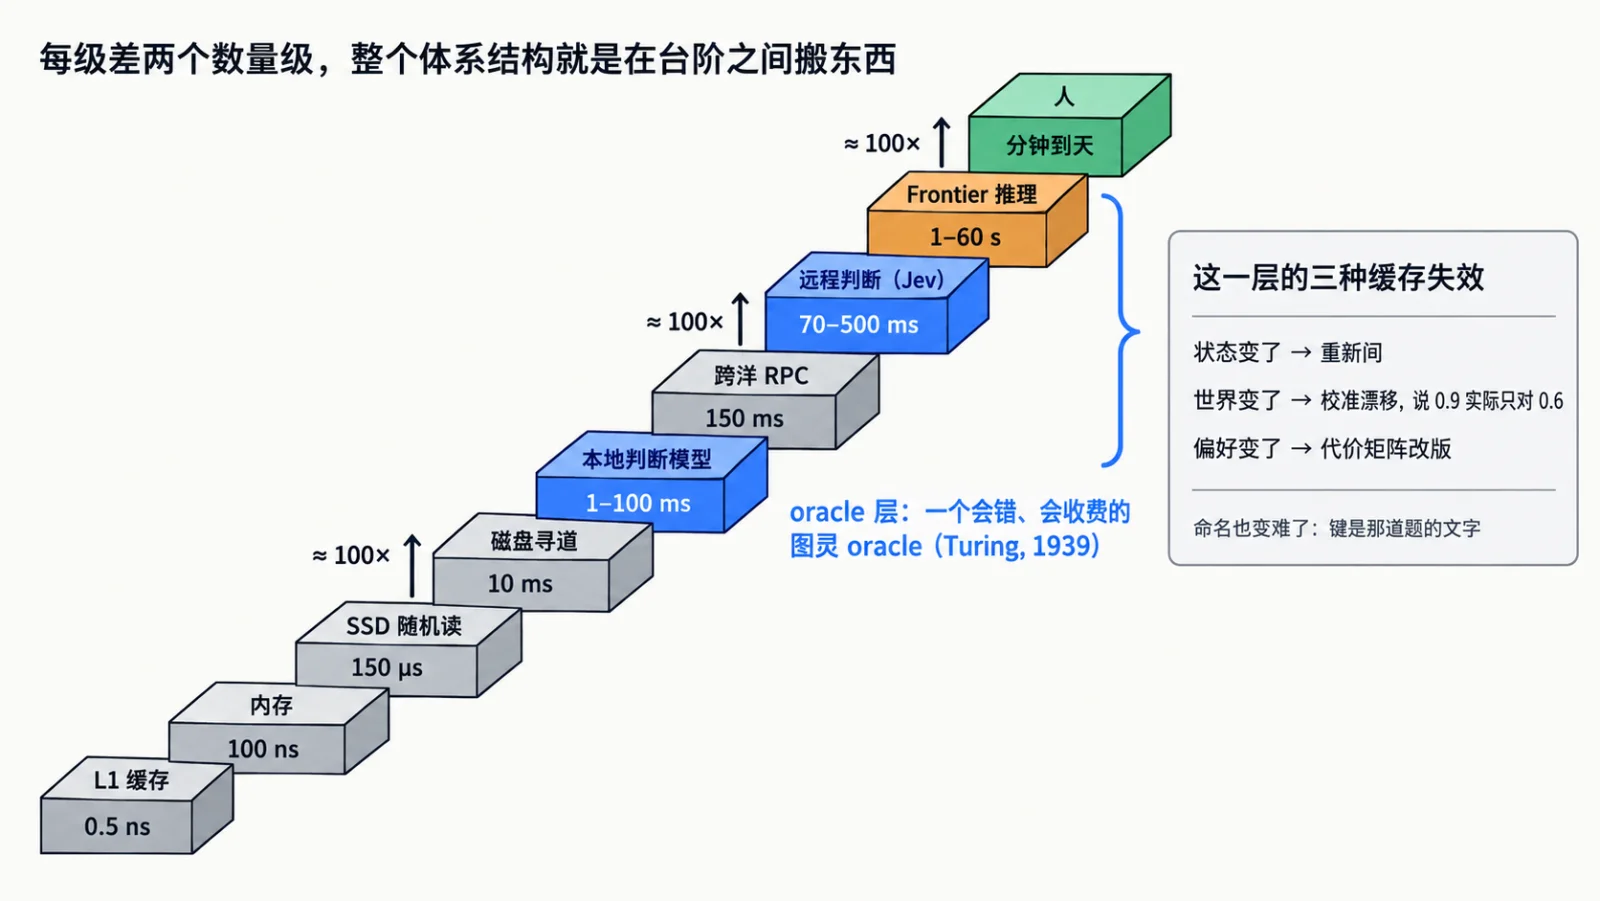
Jeff Dean 那张“每个程序员都该知道的延迟”:L1 缓存 0.5 纳秒,内存 100 纳秒,SSD 随机读 150 微秒,磁盘寻道 10 毫秒,加州到荷兰一个来回 150 毫秒。每级差两个数量级,整个体系结构就是在这些台阶之间搬东西。
现在往上接:本地小判断模型(微秒到毫秒),Jev 这类远程判断(几十毫秒,磁盘寻道和跨洋 RPC 那一档),frontier 大模型带推理(秒到分,批处理作业那一档),人(分钟到天)。台阶间距刚好还是两个数量级。它是层级里的一级。
这一级叫什么?我倾向于叫 oracle 层。图灵 1939 年提出 oracle machine:图灵机旁边放一个黑盒,问它一个判定问题,它一步给出是或否。复杂性理论围着这个黑盒建了一整套学问, 包括“要问多少次才能判定一个问题”。Jev 就是图灵的 oracle,只差两点:它会错,而且它收费。这两点差异恰好是全部新意所在。
它也是一层缓存,但要分清是哪种。结果缓存按键存答案——MySQL 8.0 把 query cache 删了,因为任何写入都让整表缓存作废,写多一点就是净亏;判断层如果做成这种缓存,state 一变得勤就重演。它真正是的是另一种:函数缓存。一个蒸馏出来的小模型没见过你这条告警,但它把“这类局面通常怎么判”压进了权重。Lampson 1983 年说“把昂贵计算的答案缓存起来”, 模型就是这个——只不过缓存的是别人经验里的计算。所以“多了一层缓存”要改一个字:多了一层物化的推理,它的失效不按键、按世界。
于是 Karlton 那句老话回来了:计算机科学只有两件难事,缓存失效和命名。
经典缓存只有一种失效:底层数据变了。判断层有三种。状态变了,重新问,这一种一样。世界的规律变了——线上换了 PG 版本、业务改了流量模式,模型压进权重的“通常怎么办”过时了, 表现为它还说 0.9、实际只对六成,这叫校准漂移。第三种经典缓存根本没有:你的偏好变了——去年漏报很贵,今年团队扛不住误报,同样的 0.7 从“叫人”变成“不叫”, 这时要改的是决策策略,不一定是模型。三种失效要三种机制:状态哈希、校准监控、代价版本,各管各的,别混着处理。
命名也变难了。缓存的键是那道题的文字。“这条告警紧急吗”和“这条告警需要立即处理吗”是两个键、两个分布、两套阈值历史。团队一多,同一个判断被问出十种写法,校准数据全碎。所以判断题需要注册、命名、版本化。Karlton 说命名难,说的是变量名;这回难的是给“问题本身”起名。
还有一件事我觉得是这一层真正的哲学分量。计算机每一层底下都是随机的:内存翻转比特,磁盘坏块,网络丢包。但几十年来每一层的工作都是把下层的随机性藏起来——ECC、RAID、TCP
重传——好让上面的软件假装世界是确定的,if 就是 if。判断层是第一个故意把不确定性往上传的层级,因为它藏不住:一个关于世界的判断,重传一百次也不会变成确定的,
只能把 0.7 原样交给应用。这个想法 1984 年就有了,叫端到端论证:只有端点知道出错的代价,所以功能必须放在端点。翻过来说:只有应用知道判断错了要赔多少,
所以概率必须传到应用层,代价必须写在应用层。
八、if 的回归,与代价矩阵
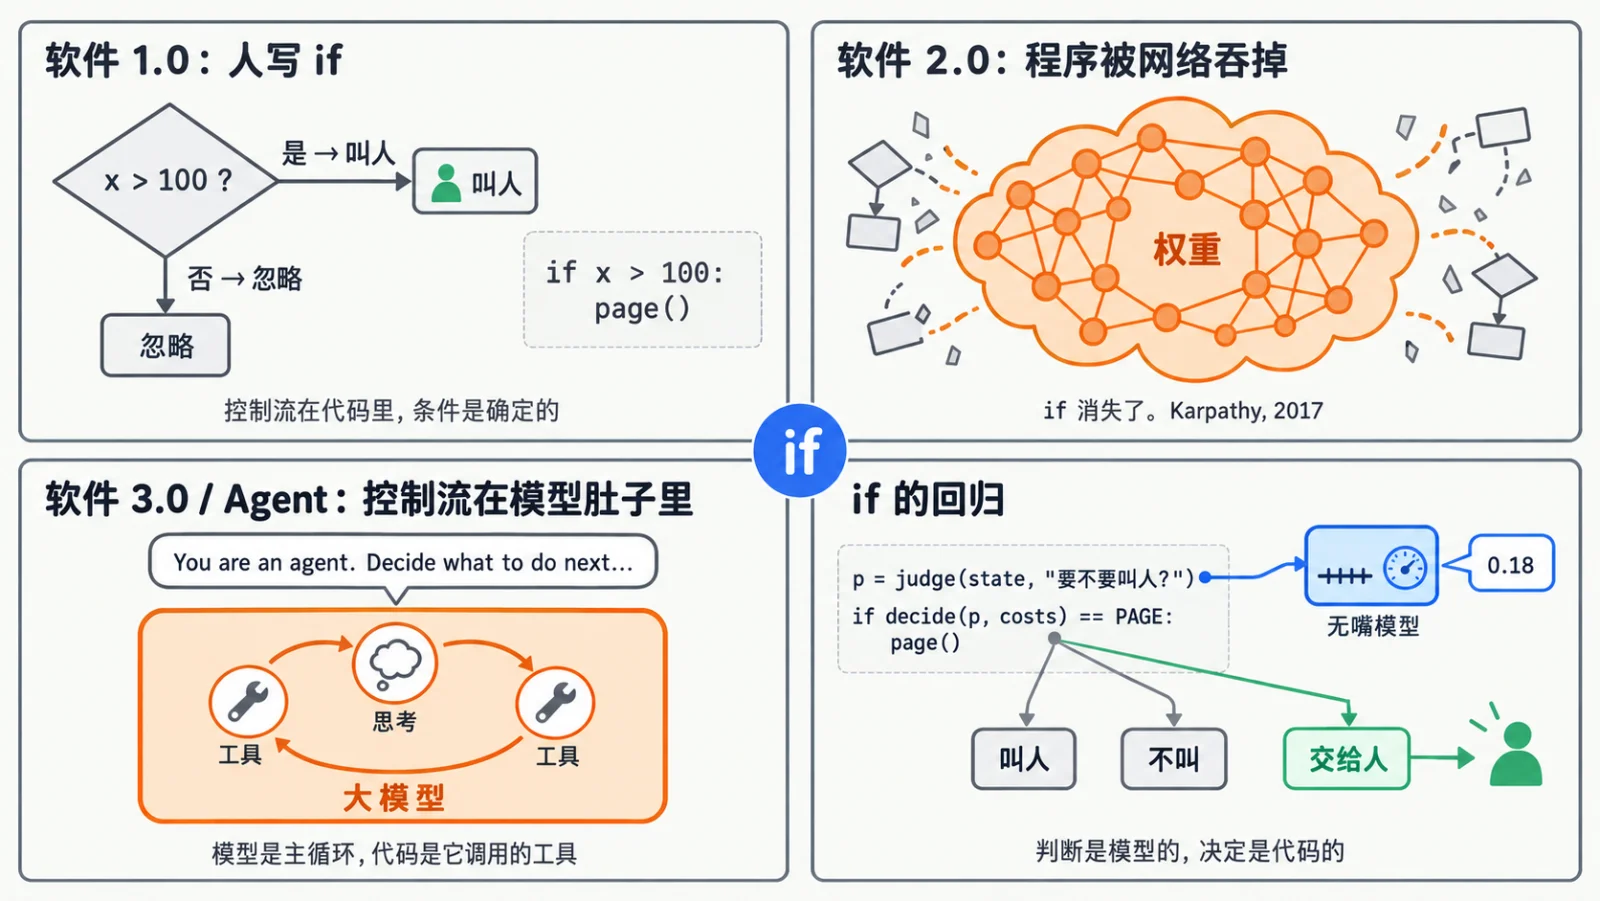
概率传到应用层之后,软件会长成什么样?
Karpathy 2017 年提出软件 2.0:1.0 是人写的代码,2.0 是训练出来的权重,整个程序被一张网络吞掉,if 消失了。后来他又提了 3.0:用英语给大模型写 prompt,控制流长在模型肚子里,Agent
是这条路的顶点。无嘴模型走的是另一条路:if 回来了。 控制流回到代码手里,还是 1.0 那种一眼能看懂的顺序、分支、循环,只是 if 括号里的条件不再是 x > 100,
而是一个网络给出的概率。程序问模型“要不要叫人”,模型回 0.18,程序自己决定 0.18 该怎么办。判断是模型的,决定是代码的。
Agent 把程序塞进模型的循环里,模型是主循环,代码是工具;这条路把模型塞回程序的循环里,代码是主循环,模型是一个返回概率的函数。它不取代 Agent, 它给 Agent 补零件——今天 Agent 烧掉的 token 里,有多少花在“这个工具返回值是不是报错”“我这步做完没”“这文件相关不相关”这种一眼题上?每道都跑一次完整推理,慢、贵,而且模型对自己的判断没有可用的置信度。
然后是最反直觉的一步。程序拿到 0.18 之后该怎么办?所有人凭直觉写 if p > 0.9。这一行代码其实藏了一句话:
“我认为误报比漏报贵九倍”——只是没写出来。而告警场景下这句话几乎肯定是错的。
先纠正一个最容易犯的错。别直接问模型“要不要叫人”,拿到 0.18 就当客观概率——“要不要”已经掺进了代价,你再用代价矩阵算一遍,等于把价值判断算了两次。更清楚的分工是: 模型估计事实,这是否符合我们定义的真实事故标准;程序结合误报、漏报、时间和权限决定动作。也别把接口里的 confidence、某个选项的概率和“这次动作正确的概率”当成同一个数——前者是从输出分布归纳出来的统计量,能不能撑住你的动作要拿业务数据验。
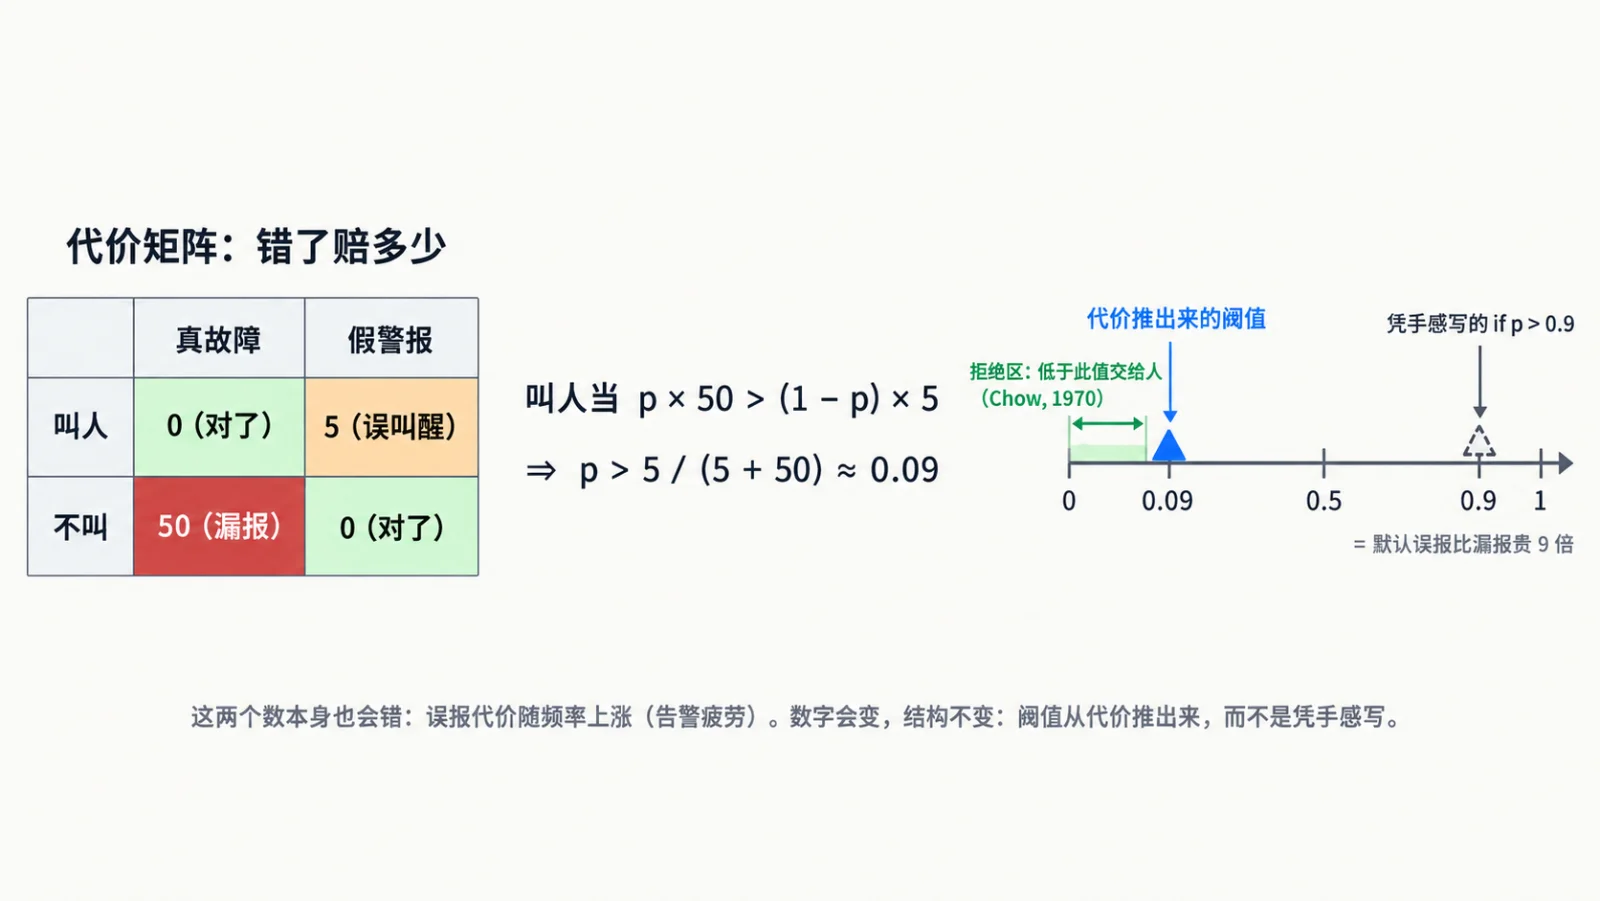
正确的做法 1970 年周绍康就证明了,叫 reject option:阈值不是字面量,它是代价的影子。漏掉一次真实故障赔 50,误叫醒一次赔 5,贝叶斯决策规则说叫人的条件是 p 大于 5/(5+50), 约 0.09。不是 0.9,是 0.09。 只要有百分之九的把握就该叫人,因为漏报贵十倍。但先把账写出来,总比把价值判断藏在一个 0.9 里强。当最大概率低于某个阈值时,最优策略是拒绝判断、交给人——那个阈值同样由拒绝的代价推导出来。你的“置信门”,就是 Chow’s rule。
所以程序员的活会变:决策层从过程式变成声明式。不再写“如果延迟大于 60 秒且持续 5 分钟且不在维护窗口就叫人”,而是写三样东西——问 oracle 什么、有哪些动作、哪种组合赔多少。阈值、升级路径、问哪几个问题,由运行时推导。这和 SQL 的跃迁同构:你声明要什么,优化器带着自己的代价模型决定怎么做。
这不是新范式,是八十年代范式的复活。MYCIN 1976 年就用“确定性因子”做过概率控制流,Heckerman 1990 年的 Pathfinder 已经是贝叶斯网络加效用函数做病理诊断。专家系统死于两件事: 知识要专家手写,写不过来;不确定性的算法不自洽,直到 Pearl 用贝叶斯网络扶正。现在第一个坎被基础模型拿掉了,第二个坎 Pearl 拿掉了。剩下给人的活恰好就是 Heckerman 当年的活:写效用。
三个但是。代价矩阵写不出来,只能引出来。 人对数值效用的判断极差。实际会发生的是:程序员给一堆例子,加上运营中每一次人工推翻系统的记录,系统反推隐含的代价——偏好学习、逆强化学习。矩阵会爆。 十个问题五个动作,联合空间没法写表,得写分解过的局部效用再相加;而且代价是跨时间的——凌晨三点误叫一次的代价不是 5, 它包含未来告警疲劳导致漏报的概率上升,贝尔曼方程出现在告警路由里。每个程序员都要面对一次小型对齐问题。 系统按你写的代价优化,你写的代价是真实目标的代理, 代理和目标之间的缝就是 Goodhart:写“减少误报”,系统学会该叫的也不叫。
升级链也不该写死。经典层级里未命中往下一级找是无条件的,没人问“值不值得去磁盘”。判断层里这本身是一个决策:是花两秒一分钱问 frontier 模型,还是现在就按 0.7 动手?Howard 1966 年给了公式,叫信息价值:多问一次的期望收益减去它的价格,正就问,负就不问。升级链于是不是配置文件里写死的四级台阶,而是每次决策现场算出来的。程序也因此多了第三个复杂度指标:时间、空间之外,查询复杂度——为了做这个决策问了几次 oracle、花了多少钱。理论计算机科学研究了几十年“决定一个函数最少要问几次”, 纯粹是数学游戏;现在每次查询标价 0.00004 美元,游戏有了账单。
九、每个程序都要长出一个优化器
如果判断层是一个拿压缩过的世界摘要做概率估计、拿代价模型把估计变成执行路径、在真正干活前决定怎么干活的组件——那数据库人应该很眼熟。这就是查询优化器。它在生产里跑了四十年, 失败模式和解药全有案可查。这是数据库领域能迁移给这件事的最大一笔资产。
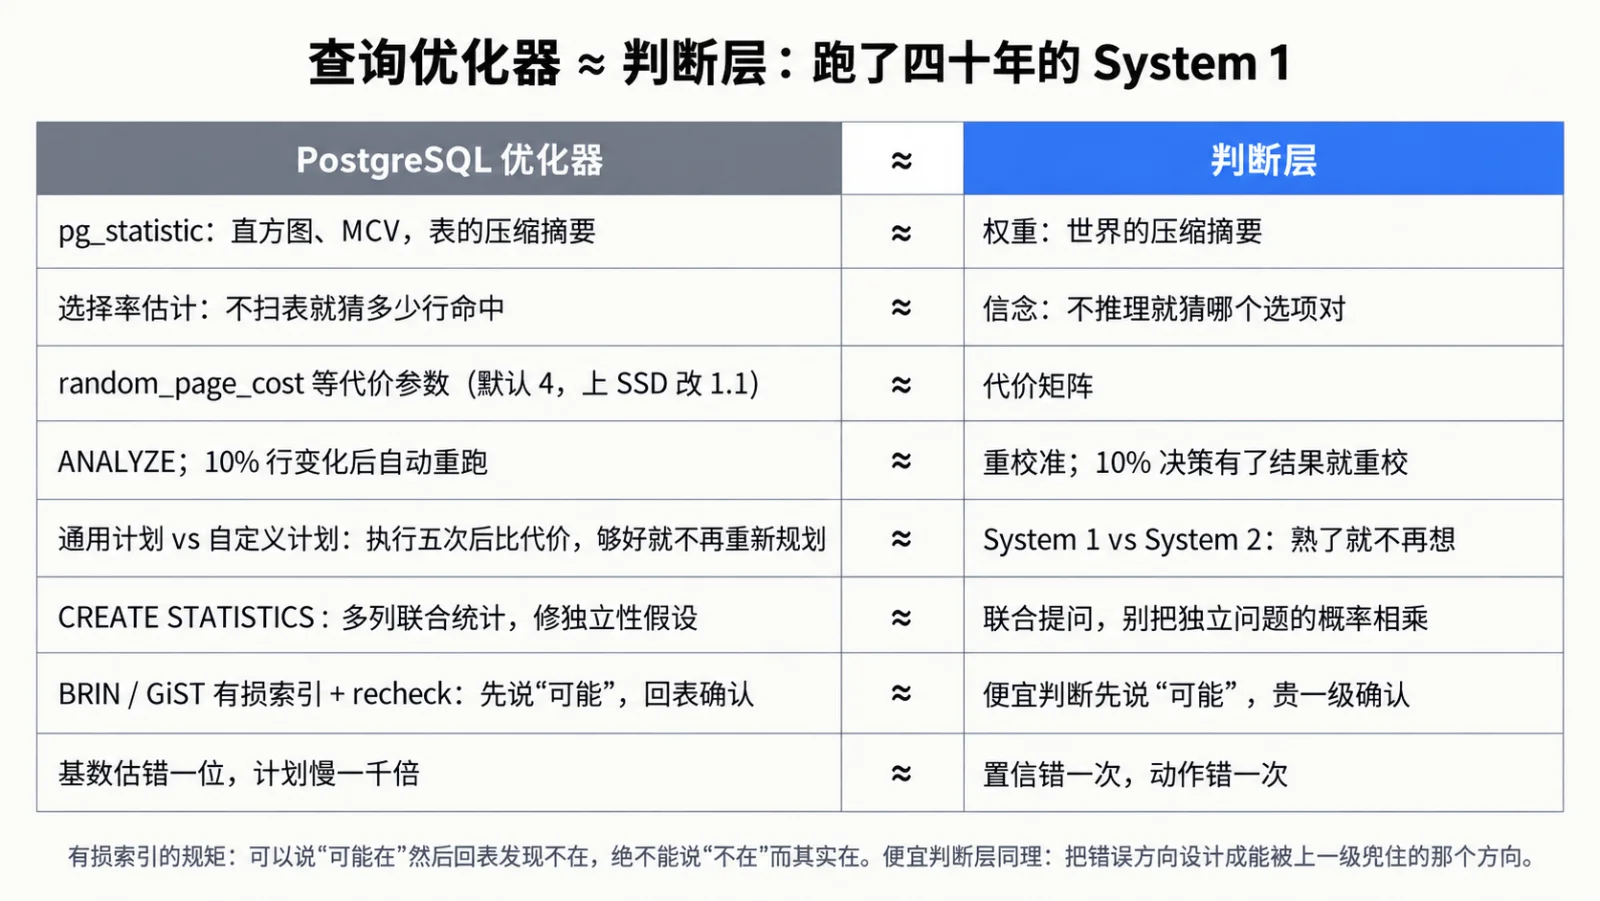
| 优化器 | 判断层 |
|---|---|
pg_statistic:直方图、MCV,表的压缩摘要 | 权重:世界的压缩摘要 |
| 选择率估计:不扫表就猜多少行命中 | 信念:不推理就猜哪个选项对 |
random_page_cost 那一族 GUC | 代价矩阵 |
| 按代价选计划:走索引还是全表扫 | 按期望代价选动作:自动走还是升级 |
ANALYZE、autoanalyze 在 10% 行变化后触发 | 重校准;10% 决策有了新结果就重校 |
| 通用计划 vs 自定义计划:执行五次后比代价,够好就不再重新规划 | System 1 vs System 2:熟了就不再想 |
CREATE STATISTICS:多列联合统计,修独立性假设 | 联合提问,修 composite scoring 的独立性假设 |
函数 COST:便宜的谓词排前面 | 确定性规则先跑,语义判断最后跑 |
jit_above_cost:只对够贵的查询做昂贵优化 | 只对够重要的决策调慢模型 |
| BRIN、GiST 有损索引 + recheck:先说“可能”,回表确认 | 便宜判断先说“可能”,贵一级确认 |
| 基数估错一位,计划慢一千倍 | 置信错一次,动作错一次 |
| plan hints | 人工 override |
| AQO、Oracle adaptive plans:拿执行反馈修估计 | 审计回填、在线重校 |
random_page_cost 那一行值得单说。默认 4,DBA 上了 SSD 改成 1.1——这就是“编程变成写代价矩阵”在数据库里的具体形态,而且它暴露了同样的毛病:默认值对现代硬件是错的,
没人知道该填几,大家 cargo cult。所以数据库社区一直在试从执行反馈里学代价参数。“代价能不能写出来”,planner 早就给了答案:写不好,得学。
有损索引那一行也值得单说。BRIN 和 GiST 的哲学是:索引可以说谎,但只能朝一个方向——它可以说“可能在这个块里”然后回表发现不在,但绝不能说“不在”而其实在。Bloom filter 也是这个原则:允许假阳性,禁止假阴性。这就是便宜判断层的正确设计:把错误方向设计成可以被上一级兜住的那个方向。 告警分诊里,多叫醒一次是可以回表的假阳性, 漏掉一次是不能回表的假阴性。神经判断器给不出这种单向保证,能做的是把系统设计成偏向保守升级——这是一种设计偏好,给不了数学保证。
数据库用四十年学到的三个教训,可以照抄。
第一,估计进入控制流的代价是重尾。 选择率估错一个数量级,不是慢 10%,是慢一千倍——嵌套循环 join 在错误估计下的惨状每个 DBA 都见过。判断层会有一样的形状:99% 的决策省了钱,1% 捅了大娄子。解药也现成:鲁棒查询优化不追求期望最优,而是选在估计误差范围内都不太糟的计划。决策论里叫 minimax regret——尤其在动作不可逆的时候。
第二,独立性假设是万恶之源。 planner 几十年来最臭名昭著的错误来自把多个谓词的选择率直接相乘,当它们相关时差出几个数量级。PG 10 加 CREATE STATISTICS,PG 12 加多列 MCV,
就是在补这个洞。TypeSafe 推荐的 composite scoring 把同一个 state 上十个问题的概率加权求和,犯的是同一个错——它们从同一段状态里读出来,错会一起错。多问几个问题也不等于多几份独立证据:同一份状态交给同一个模型问十种相近的题,很可能只是让它把同一个误判重复十遍;把不同维度加权成综合分数没问题,但别把综合评分当成概率,
更别把高度相关的判断当成十位互不认识的专家一致投票。
第三,学习型估计器死在失效上。 2019 年前后一批工作用神经网络替代直方图做基数估计——Naru、DeepDB、MSCN——精度碾压传统方法。2021 年 VLDB 有一篇《我们准备好用学习型基数估计了吗》,结论是没有:数据一更新模型就过时,重训太贵,而且偶尔的离谱错误比稳定的平庸错误更致命。这几乎是给判断层写的预告片。神经判断器进生产的瓶颈不在准确率,在失效检测和重校的成本。活下来的是 AQO 那种路子:不追求一次训好,持续拿执行反馈修正。
几个短的同构,每个都能落成一条工程实践。审计表是决策的 WAL:先记(state 哈希、信念、代价版本、动作)再动手,最终结果回填。决策要有快照隔离:判断在 t 时刻的 state 上做出,
动作在 t+Δ 执行,中间状态可能变了,解法是乐观锁,decide() 返回动作和 state 哈希,act() 先确认哈希没变。小模型是有复制延迟的从库:它从旧一版 frontier 蒸馏而来,
永远落后主库一截,数据库对“哪些读可以走从库”有明确规则,判断层也要有。上一级推翻下一级的每一条记录,就是 Dynamo 的 read-repair,也是下一次蒸馏的样本。
但别顺手把 PITR 也搬过来。数据库能重放已经记录的变化,决策系统却不能凭日志知道没发生的世界——当时叫醒了 DBA,故障修好了,不代表不叫人也没事;换阈值能重算当时会选什么, 算不出换动作后的真实后果,那需要反馈数据和评估设计。日志是起点,不是时间机器。
十、Harness 会怎么变
把上面这些落到 Agent 的 harness 上,会发生六件事。判断外包:终止检查、工具结果校验、相关性过滤、安全检查全部下沉到快层,大模型只在真正的岔路口思考,agent 的 token 账单里三成到一半会这样省掉。推理预算路由:先用一个便宜判断估“这一步有多难”,再决定给多少思考 token。投机执行:按可能走的分支预取工具、预判结果, 猜错丢弃——分支预测进 agent。置信度门控的自主权:权限不再是静态白名单,可逆动作看置信度,不可逆动作看背书,动作分类学成为 harness 的核心数据结构。元认知层: 一个快模型盯着 trace 问“是不是在打转”“是不是偏了”,agent 第一次有了预感。多 agent 退潮:一个推理者加一群便宜判断者,比一群互相聊天的 agent 便宜、可审计、好调试。
但别借机把所有规则都换成概率:维护窗口、权限、对象是否存在、SQL 是否满足硬约束,能由程序确定的继续由程序确定,模型补的是规则难写的部分。
副作用:模型商品化之后,harness 成为护城河——问题库、代价表、升级策略、结果日志,这四样在你手里,模型可以随便换。
十一、零幻觉的真相
写到这儿该泼冷水了,不然这篇就成了软文。
TypeSafe 最响的宣传是“不会幻觉”。翻译一下:它说的是类型安全——输出一定在你给的选项里,不会冒出不存在的类别,不会 JSON 缺括号。这是构造上的保证, 他们自己也承认那个“0% 幻觉”是按定义填的,不是测出来的。但从五个选项里选错一个,它完全可能。格式保真,判断照样会错。输出受约束也不等于输入攻击失效: 攻击者不需要让模型说一句越界的话,只要把它推向错误的合法选项。
“快 193 倍、便宜 444 倍”是拿它跟一个先写推理再吐 JSON 的大模型比的,官方也说这是“现实收益的高端”,参考标签是强模型的判断而不是事实。他们用 DSPy 做的一个小 demo, 整条流水线只快了 15.9%、便宜了 30%。它自家公布的 benchmark 上准确率六成八,跟中档模型一个水平;一家做金融研报评分的团队跑了六千次对比, 它跟最强模型的判断一致率九成出头——一致率不是准确率,最强模型之间彼此也不会百分之百一致。所以它是一个“便宜到可以多请一位读者”的东西,不是可以当最终裁判的东西。
而且前面说过,普通 LLM 读单个 token 的 logit 已经拿到大部分加速。所以 Jev 真正需要证明的不是能不能“闭嘴”,而是闭嘴之后是否同时具备:跨任务的理解、多问题并行的效率、有意义的概率校准、完整服务的低成本和稳定性。比较对象不该只有“让最贵的推理模型写一份带概率的 JSON”,还得有单 token 判断、专用分类器、reranker、针对业务蒸馏的小模型。只有专门训练的判断模型相对单 token 读 logit 还有明显优势,收益才能归到“专门的模型与接口”上,而不只是少生成了一篇文章。
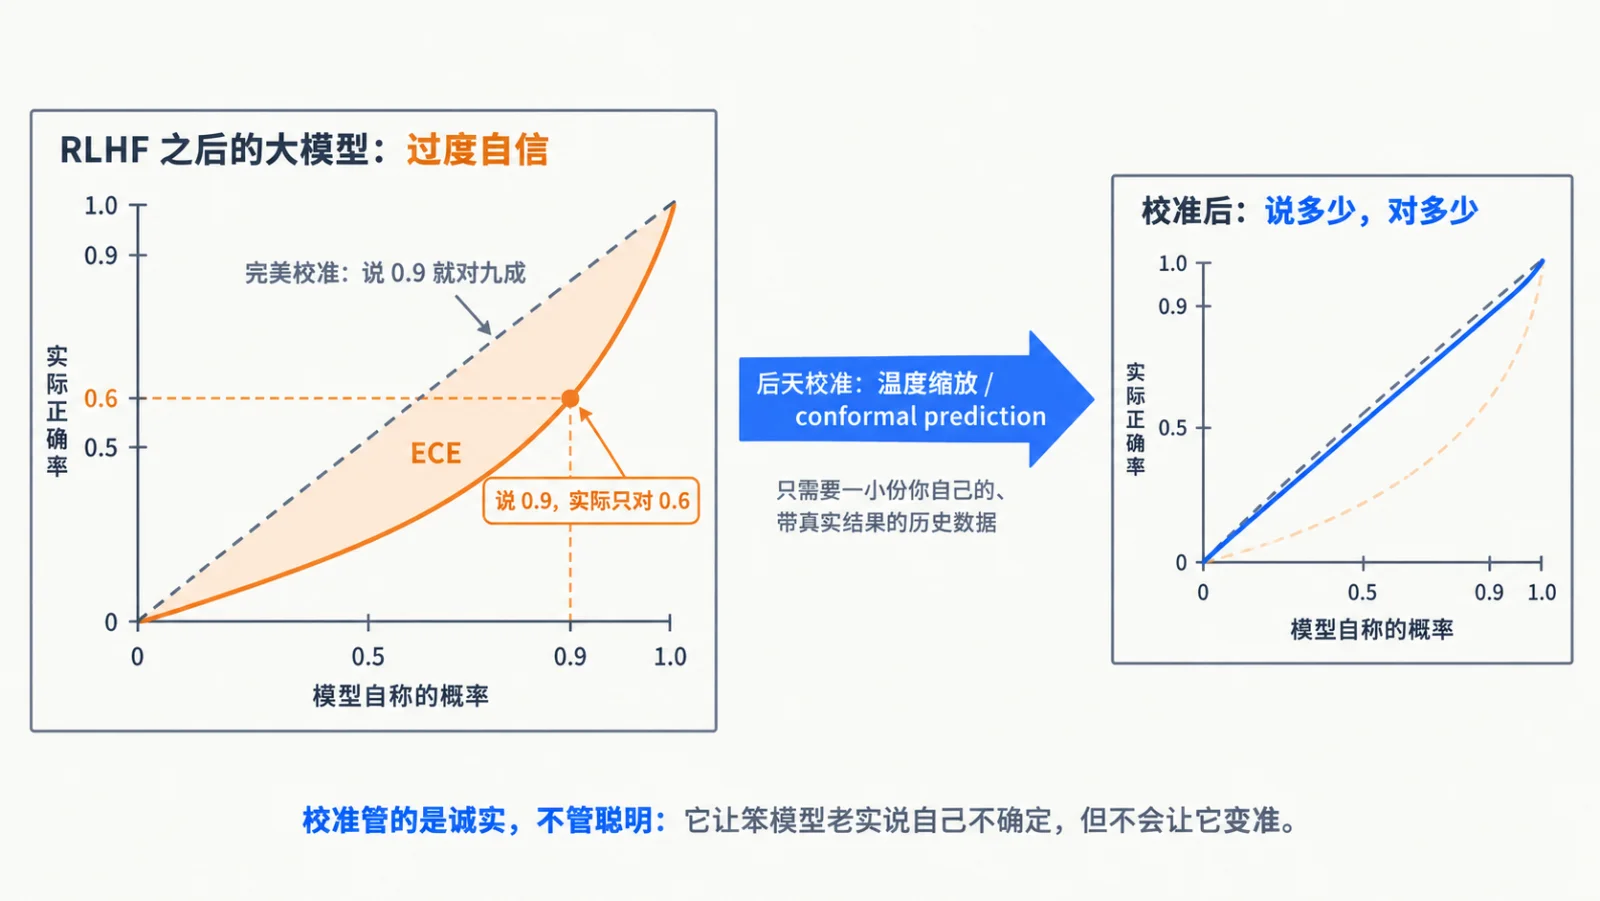
真正有可能是新东西的,只有一样:校准。
校准的意思大致是:报九成的那一组预测,最终确实有约九成成立。它说的是一组预测整体上诚实,给不了单次的保证。而且诚实不等于聪明:在正负各半的数据上, 一个永远回答 0.5 的模型校准得完美,却毫无区分能力。所以要同时看两件事:它能分清多少问题,它对自己的错误有没有可靠的信号。落到自动化上就是: 在可接受的风险下,能让多少任务不再打扰人。
大模型缺的恰恰是“知道自己不知道”——它说 90% 的时候实际可能只对六成。直觉之所以可用,靠的不是快,是那份靠得住的不确定感。如果 RLCD 真能让 0.9 意味着九成正确, 那“可信的犹豫”作为一个原语就是新的。但截至今天这一项零公开证据:没有论文,没有权重,没有 ECE、Brier、可靠性曲线这些校准领域的标准指标。 “calibrated” 是一个 claim,不是一个 result。
不过有一个转折:校准可以后天做。 温度缩放、conformal prediction 这类方法,只需要一小份你自己的、带真实结果的历史数据,就能把一个没校准的打分器校准到有统计保证的覆盖率。校准管的是诚实不管聪明——它只能让一个笨模型诚实地说自己不确定,不能让它变准,数据一漂移还得重校。但对“该不该自动处理”这个问题,诚实恰恰比聪明重要。这也接上了《小脑》:模型给的是种群的直觉,你本地那张审计表——每一次判断的概率、最终有没有叫人、叫对了没有——才是把它变成“你的”那块小脑。护城河不在模型里,在 outcome 数据里。
还有一个反方必须写。判别式的 judge 有天花板。2025 年 reward model 那条线的进展方向恰恰是反的:GenRM、DeepSeek-GRM 都发现让评判模型先推理再打分,在难题上更准。System 2 在最难的判断上仍然碾压 System 1。所以 System 1 是地板不是天花板,值钱的不是它单独有多准,是交接——高置信的自动走,低置信的升级。这在机器学习里叫 selective prediction、learning to defer、model cascade,二十年文献,不用重新发明。
十二、脊髓里的依赖
有件事比“是不是新东西”更重要。
大模型今天在软件里的位置是边缘的:一个聊天框,一个总结功能,一个后台 Agent。它挂了,产品少一个功能。无嘴模型进入的位置是控制流,是每一个 if 的判断权。LLM 依赖在软件的皮肤上, 这种依赖在软件的脊髓里。 没有一个正经的系统能接受控制流跨洋。本地可部署的判断模型是这个范式成立的前提,不是锦上添花。TypeSafe 是美国托管的闭源 SaaS,这条路它自己走不通,但会有人替它走通。
远程服务不是一概不能用,但程序的基本行为不能绑死在一个你无法控制、无法替换的 API 上。它超时了怎么办?网络断了默认放行、默认拒绝,还是回到原来的规则? 这些必须由你决定,不能留给一次 HTTP 请求的命运。
开源替代会来得很快,比 DeepSeek 复现 o1 的四个月还快。理由有三。无嘴模型早就存在,只是没这么包装——reward model 就是 decoder 后面接一个 value head 吐一个分数, 每家实验室手里都有一堆;Llama Guard 是无嘴模型,reranker 是无嘴模型,零样本分类器 GLiClass 已经能在一次前向里完成任意标签的分类。配方简单、推理栈现成——任何开源 decoder 加一个选项头,用 proper scoring rule 当损失,再来一点 RL 做校准;vLLM 早就支持 classify、reward、score 模式。社区甚至已经出现了叫 LFM2.5-2.6B-RLCD 的实验,复用共享上下文并行评价选项——作者老实声明没做 RLCD 训练、没完成校准,但这说明接口层面的门槛有多低。第三,TypeSafe 自己评测的参考答案是 GPT-6 Astra 和 Claude Fable 5.1 的平均,“把 frontier 的直觉蒸馏进小模型”这条路摆在那儿,对 Qwen 和 GLM 毫无障碍。
所以要把替代分成两层看:复制接口和工作方式,门槛不高;复制可靠的通用判断能力——换业务、换语言、换选项之后还稳、置信度还有用——门槛高得多,需要训练、数据和评测, 不是给 softmax 套一层 API。方向有价值,不意味着第一个喊响方向的公司拥有全部价值。价值会转移到三处:各领域带真实结果的校准数据集、判断题的 schema 库、能跑在 NPU 上的端侧运行时。TypeSafe 大概率是“发明了 embedding API 的那家”,不是靠它赢的那家。
随之而来的还有决策通胀。当判断免费,系统会长成一锅没人能审计的概率分支汤——每个 if 后面一个模型,每个模型一个版本,每个阈值一段历史。谁判断的、依据什么状态、给了什么概率、最后对不对,得有地方存、能回放、能回填。GDPR 第 22 条“有权要求人工介入”就是法律版的“升级到负责任的那一级”,欧盟 AI 法案的日志留存和人工监督要求恰好对应决策 WAL 和置信门。监管者迟早会像索要渗透测试报告一样索要校准报告。
而这些东西——压缩的统计摘要、代价参数、按代价选路径、统计过期自动刷新、执行反馈、WAL、时间点重放、权限控制、触发机制——PostgreSQL 一样不缺。一个语义判断做成带 COST 的函数,planner 自动把它排在确定性谓词之后;审计表就是普通表;代价矩阵是一张配置表;RLS 决定谁有权给高风险动作背书;触发器就是置信门。决策平面最自然的宿主不是一个新框架,是数据库本身。 别的软件要从头长一个优化器,数据库里已经有一个,只是它以前只优化 SQL。
但宿主不等于把模型调用塞进每个事务、拿着锁等一次网络往返。数据库负责记账和治理,推理服务负责计算,执行系统守住动作边界。SQL 优化器知道一个函数很贵,
却不会因为你填了 COST 就懂一次漏报值多少钱;外部动作也不会因为事务回滚就跟着没发生。
明天开始做,顺序很朴素。先挑一道反复出现、边界清楚、错误可发现的问题。把状态、判断、人工处理和最终结果记下来,这张表比模型重要。写清楚动作代价与硬约束,哪怕写错, 写出来的错代价也比藏在 0.9 里的代价好。让模型跑影子模式,只看它会怎么判,不让它接管。等反馈覆盖了典型情况和足够多的异常,再从低风险、可逆的动作开始。别第一天就把值班电话拔了。
十三、预测
一篇讲校准的文章,作者该敢给自己的预测标概率。以下从 2026 年 9 月 18 日起算,是押注,到期逐项结算 Brier 分数。
| 预测 | 时限 | 概率 |
|---|---|---|
| 可本地部署、多问题、带概率的开源判断模型出现 | 12 个月 | 0.9 |
| 主流工作流引擎加原生 judge 步骤 | 2 年 | 0.85 |
| 主流 Agent 框架把终止/校验/路由下沉到快层成为默认 | 18 个月 | 0.75 |
| 判断力加校准的公开排行榜(MTEB 之于 embedding) | 12 个月 | 0.7 |
| 主流告警路由支持概率匹配器 | 2 年 | 0.7 |
| 端侧持续判断成为语音/相机之后的主流 NPU 负载 | 3 年 | 0.6 |
| 云数仓的语义谓词输出校准概率并支持代价排序 | 2 年 | 0.6 |
| OpenTelemetry 出现决策语义约定 | 3 年 | 0.6 |
| 判断 API 按请求而非按 token 计价 | 2 年 | 0.6 |
| 监管开始索要校准报告或风险覆盖曲线 | 5 年 | 0.5 |
| 主流编程语言加入不确定性相关关键字 | 10 年 | 0.2 |
| TypeSafe 成为这个品类的长期赢家 | 5 年 | 0.15 |
| HBM 总需求因此下降 | 任何时限 | 0.05 |
三件事会让这一切不成立,按威力排:判别式判断的天花板太低,那它永远只是前置过滤器,影响缩水一半;校准在分布外做不出来,那它只在闭环行业成立;推理 token 价格掉得比预期快, 成本优势归零,只剩延迟优势。所以再说一遍两根桩子:延迟优势是结构性的,成本优势是暂时的。 靠“便宜四百倍”立论的都要打折,靠“一百毫秒、进请求链路”立论的可以不打。最终算账要在质量过关的前提下——把正确率一起砍了,当然什么都能变快。
尾声:闭嘴是便宜的
绕回开头那条告警。
老 DBA 盯着监控说“这味儿不对”的时候,脑子里跑的不是一条推理链。CPU、IO、连接数、复制延迟、业务流量放在一起,某个组合让他心里一紧。这是识别,这是 System 1。用 Jev 的话说, 是一个 Noul:一个二元判断,附带一个概率。
无嘴模型让这个动作可以被便宜地工程化:读一段状态,给一个概率,一百毫秒,几乎不要钱,题目随便换。告警该不该叫人、工单该归谁、这条 SQL 像不像误操作,都是它的主场。
但有一条线要划得非常清楚:控制环不能交给它。failover、恢复备份、DDL、删数据,这些操作的最终授权不能来自一个不会解释自己的模型,不管它说自己有多确定。它可以贴标签、路由、叫人, 不能动手。高风险动作需要事前证据、硬约束和责任边界——概率不能自行兑换成权限。 99% 的判断不需要解释,剩下 1% 让会说话的 System 2 事后来补——先有直觉,再把直觉翻译成路径。层级的顶端放人,也不是因为人的准确率最高,是因为人能被追问、被处分、被起诉。责任这种东西,目前只有人能产出。
《两个半球》讲架构:智能需要两种不可化约的计算范式。《小脑》讲身体和历史: 直觉需要个体化的经验来校准。这一篇讲接口和经济:直觉怎么被定价、怎么被交付、怎么进入软件的请求链路。
大模型让机器学会了说话。Agent 让机器学会了动手。
这一波,让机器学会了闭嘴。
而闭嘴,是便宜的。